D4D: An RGBD diffusion model to boost monocular depth estimation
方法
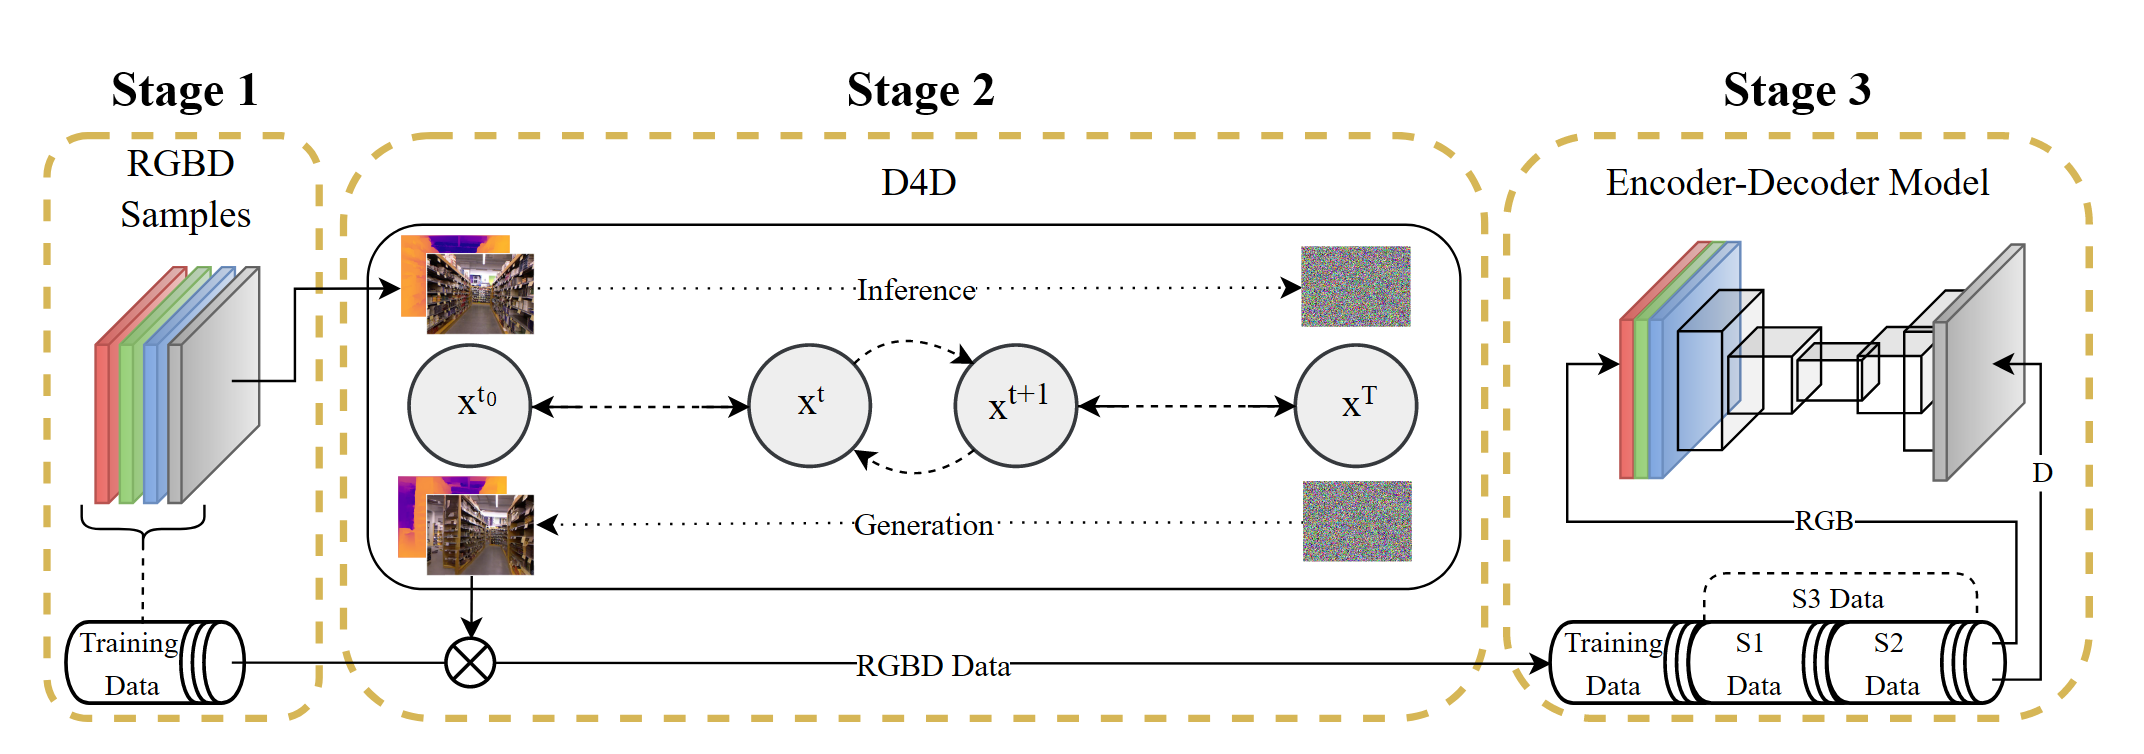
阶段一
对NYU和KITTI中的RGBD样本进行预处理,进行归一化以及rescale,分辨率跟第三阶段所采用的model有关
阶段二
第二阶段对输入的RGBD进行前向和后向操作训练网络,同时通过S1和S2两种不同的训练配置,得到不同的生成数据,其中$S1$使用$L1$ loss,$β$策略采用线性策略,$S2$使用$L2$ loss,$β$采用余弦策略
最终得到的$S3$就是$S1$和$S2$的并集
最终用于后续训练的增强训练数据集由$S3$和原始的训练数据组成
阶段三
用构建的增强训练数据集对多个model进行训练
 微信
 支付宝
相关推荐
2026-07-20
ARDepth: Auto-regressive Monocular Depth Estimation with Progressive Visual Conditioning
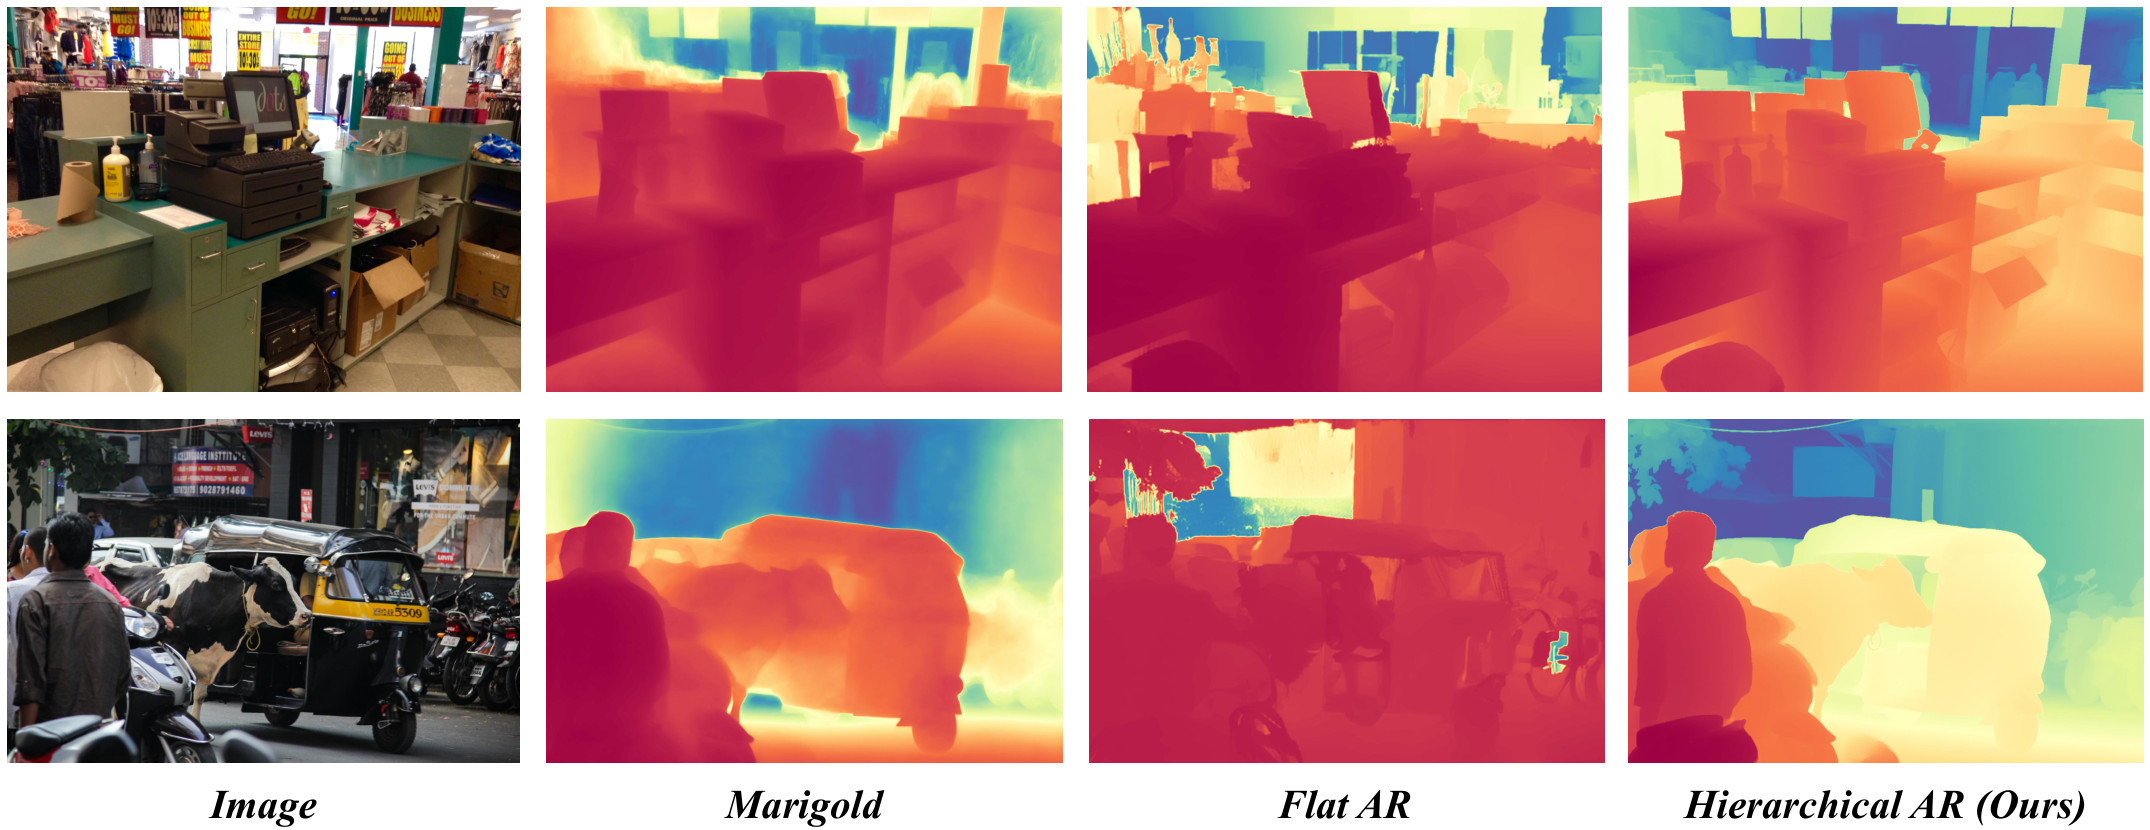
作者:Zijie Wang, Wei Zhang, Weiming Zhang, Xiao Tan, Weikai Chen, Xiaoxu Li, Guanbin Li 单位:Sun Yat-sen University, Shenzhen Loop Area Institute, Baidu Inc., LightSpeed Studios (Tencent America), Lanzhou University of Technology 会议:2026 Arxiv(Under review) 链接:https://arxiv.org/abs/2607.12433 文中图表均引自原论文;该 arXiv 版本标注为 CC BY 4.0。 研究动机当前零样本单目深度估计常借助扩散模型:把深度视为一张全局连续的场,经由多轮去噪逐步恢复。但真实几何并不总是平滑的——遮挡边界、细杆、表面相交处恰恰是离散且有层级的高频结构。作者认为,统一的全局去噪并没有显式表达“先有整体布局、再有表面与边界”的构造过程。 另一条路是视觉自回归(AR),但把完整深度图拉平成单一长序列的 Flat...
2026-05-19
Lotus-2: Advancing Geometric Dense Prediction with Powerful Image Generative Model
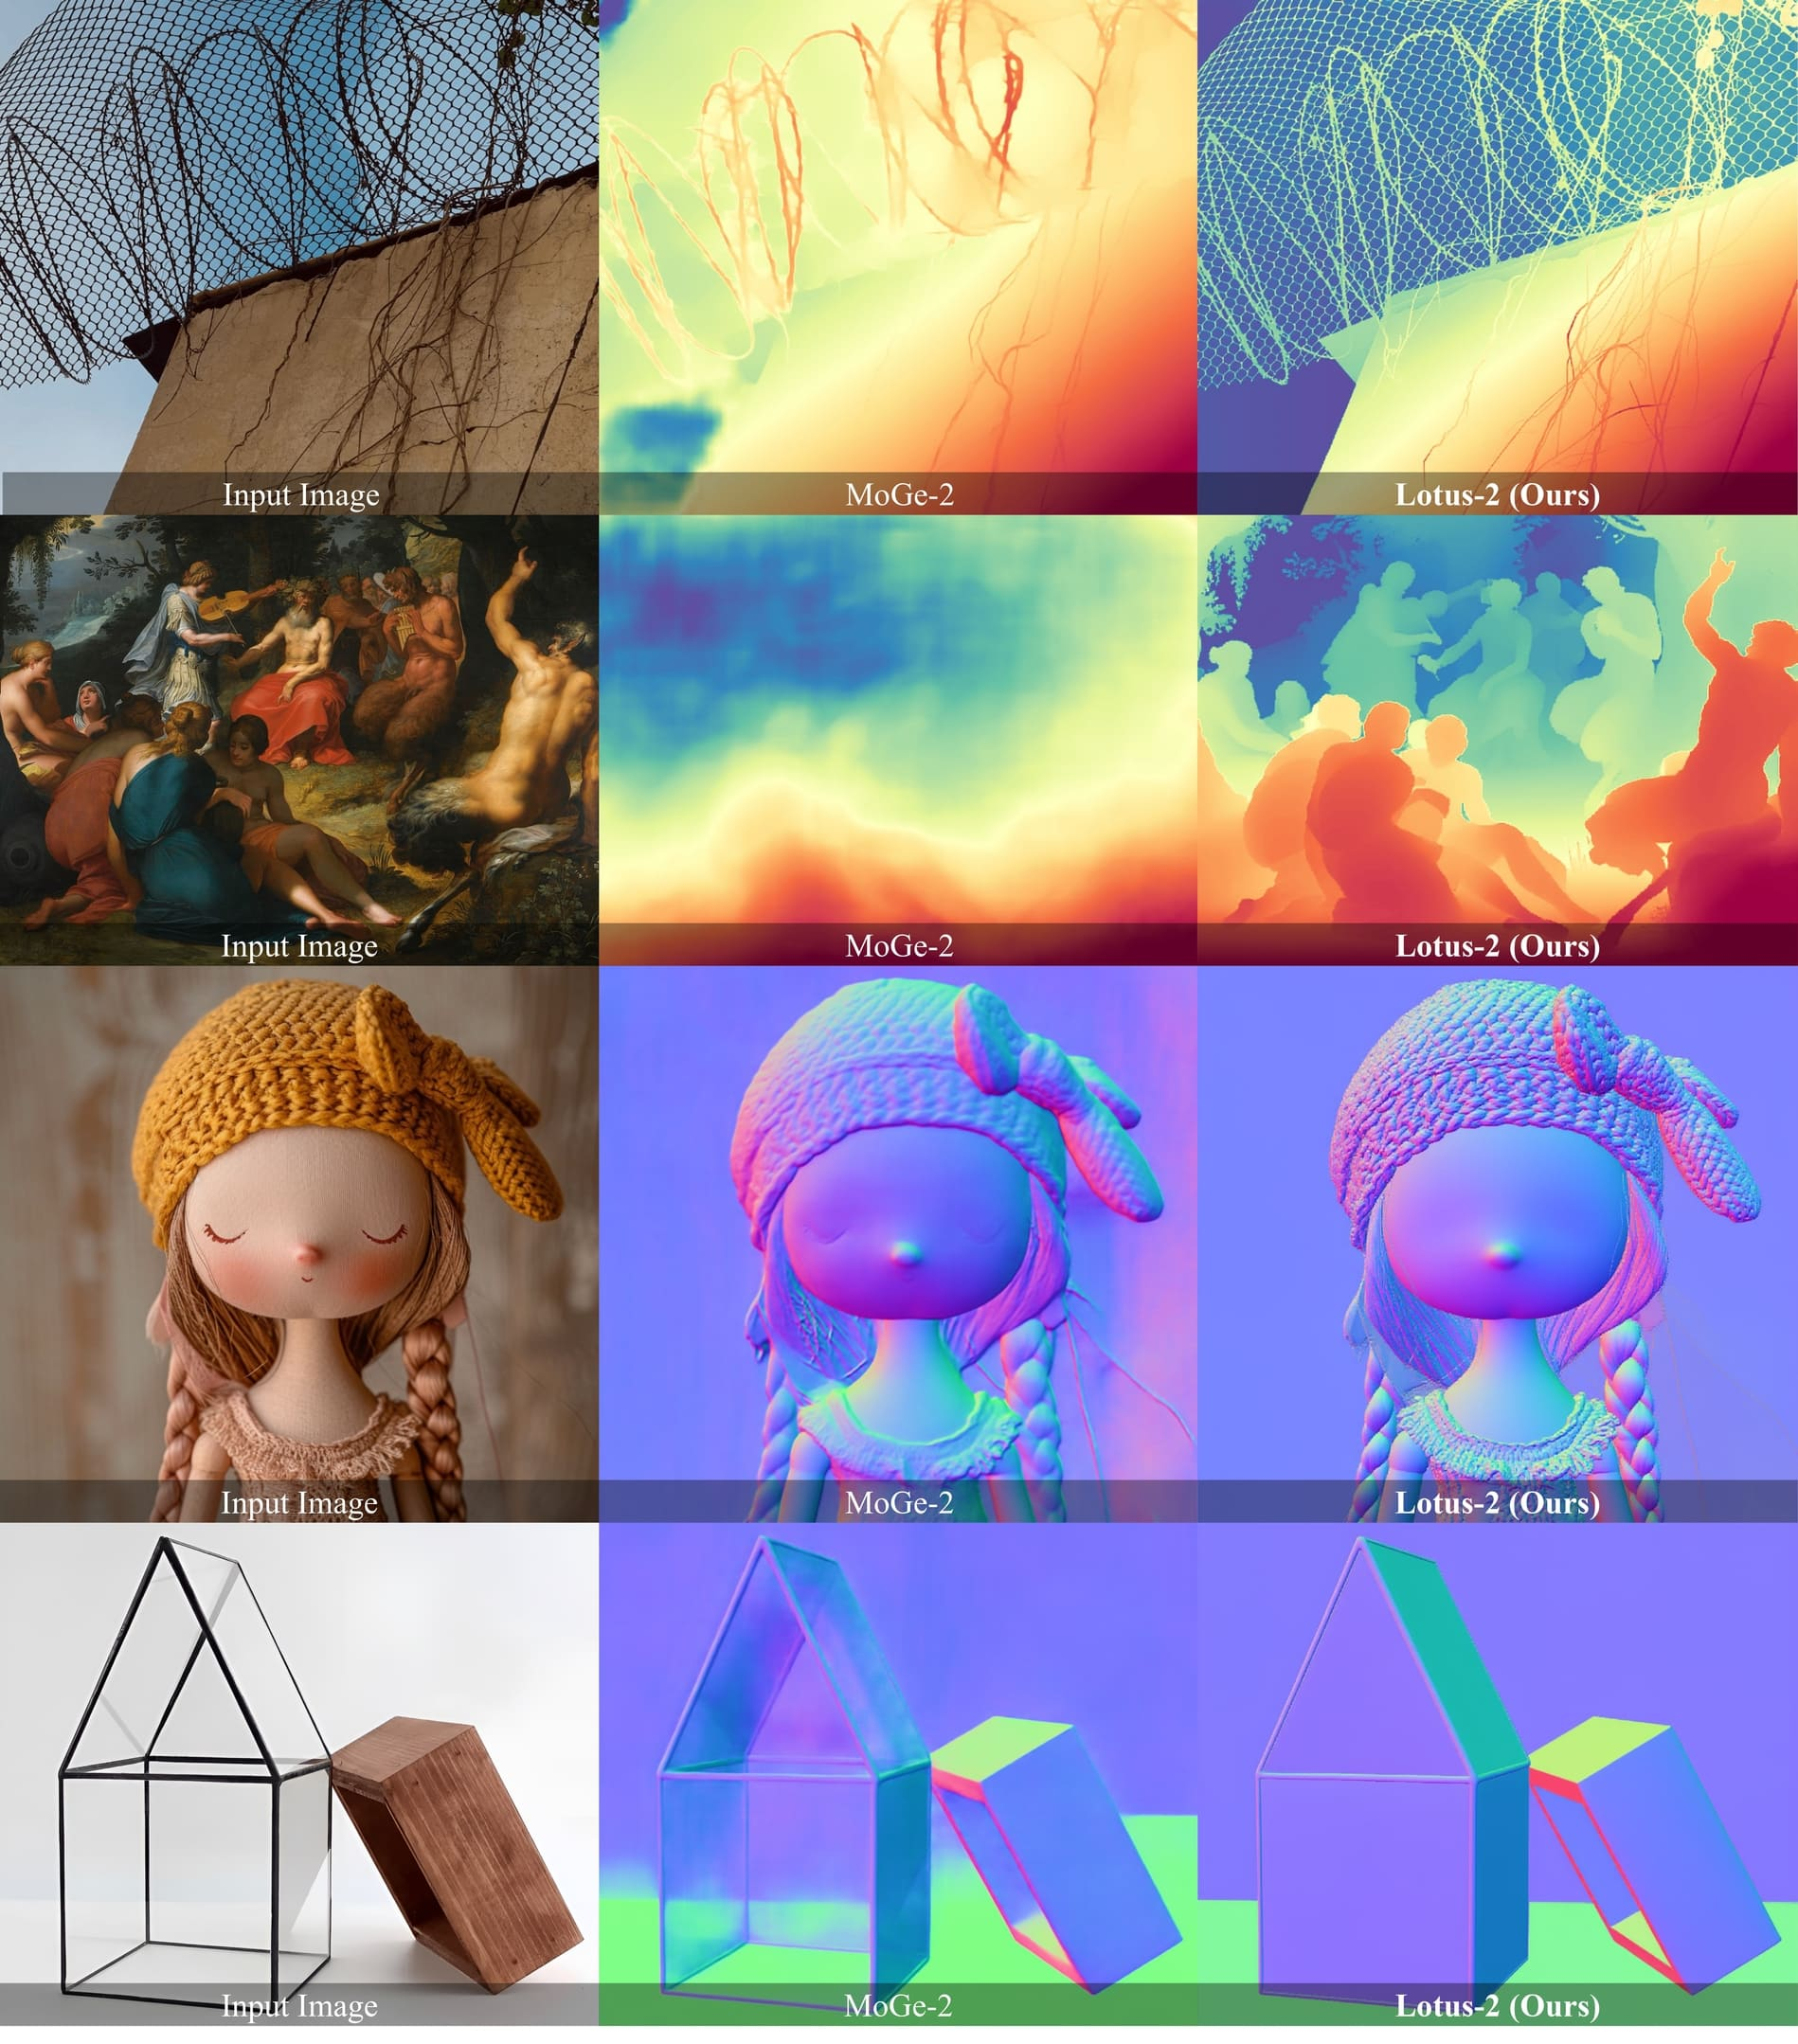
作者:Jing He, Haodong Li, Mingzhi Sheng, Ying-Cong Chen 单位:HKUST(GZ), UC San Diego, HKUST 会议:2025 Arxiv 链接:https://arxiv.org/abs/2512.01030 研究动机 这篇文章讨论的是一个很尖锐的矛盾:单目几何密集预测本质上是病态问题,但现在最强的两类路线各有明显短板。 大规模判别式深度模型依赖海量监督数据,性能上限很大程度由训练集规模、真实性和标注质量决定,一旦遇到稀有场景或开放域图像,泛化就容易掉下来。 扩散/rectified-flow 这类生成模型确实在海量图文数据里学到了强 world prior,但它们原生的随机采样、多步生成和高保真图像目标,并不天然适合“同一张图稳定输出一张几何图”这种确定性任务。 如果直接把生成模型的随机生成范式搬过来,模型会出现结构方差、几何幻觉和推理开销过高的问题;但如果完全退回普通回归模型,又拿不到生成模型里蕴含的大规模几何先验。 所以 Lotus-2...
2024-12-08
SSD:Stealing Stable Diffusion Prior for Robust Monocular Depth Estimation
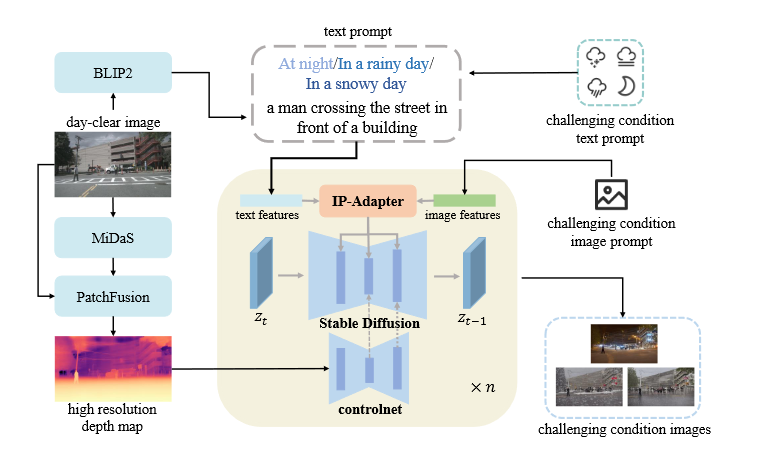
背景现有的MDE方法在标准的环境下(例如晴天)表现的很好,但是在一些具有挑战性的条件下效果会变得很差,这主要是由于一些关键的假设失效了,例如光度一致性假设,同时也没有可靠的ground truth包含这些场景。 现有的一些鲁棒的解决方案 基于模型的方法 这一方法通过修改网络结构来增强模型处理各种条件的能力 缺点:网络模型过于复杂,不能够适应各种环境 基于数据的方法 利用域自适应或其他模态的数据来增强图像信号 缺点:缺乏高质量的数据,需要后处理 方法Generative Diffusion Model-based Translation生成在深度方面与白天清晰图像非常相似的训练样本 I_{g}=S D ( I P ( T_{p}, I_{p} ), C N ( D_{h} ), z ) BILP2:获取场景描述符,保留图像内容信息 ControlNet d2i:保持近似深度一致性 MiDas:获取初始深度图 PatchFusion:获得高分辨率的深度图 text prompt=BILP2 场景描述符+challenging condition...
2024-12-08
BetterDepth: Plug-and-Play Diffusion Refiner for Zero-Shot Monocular Depth Estimation
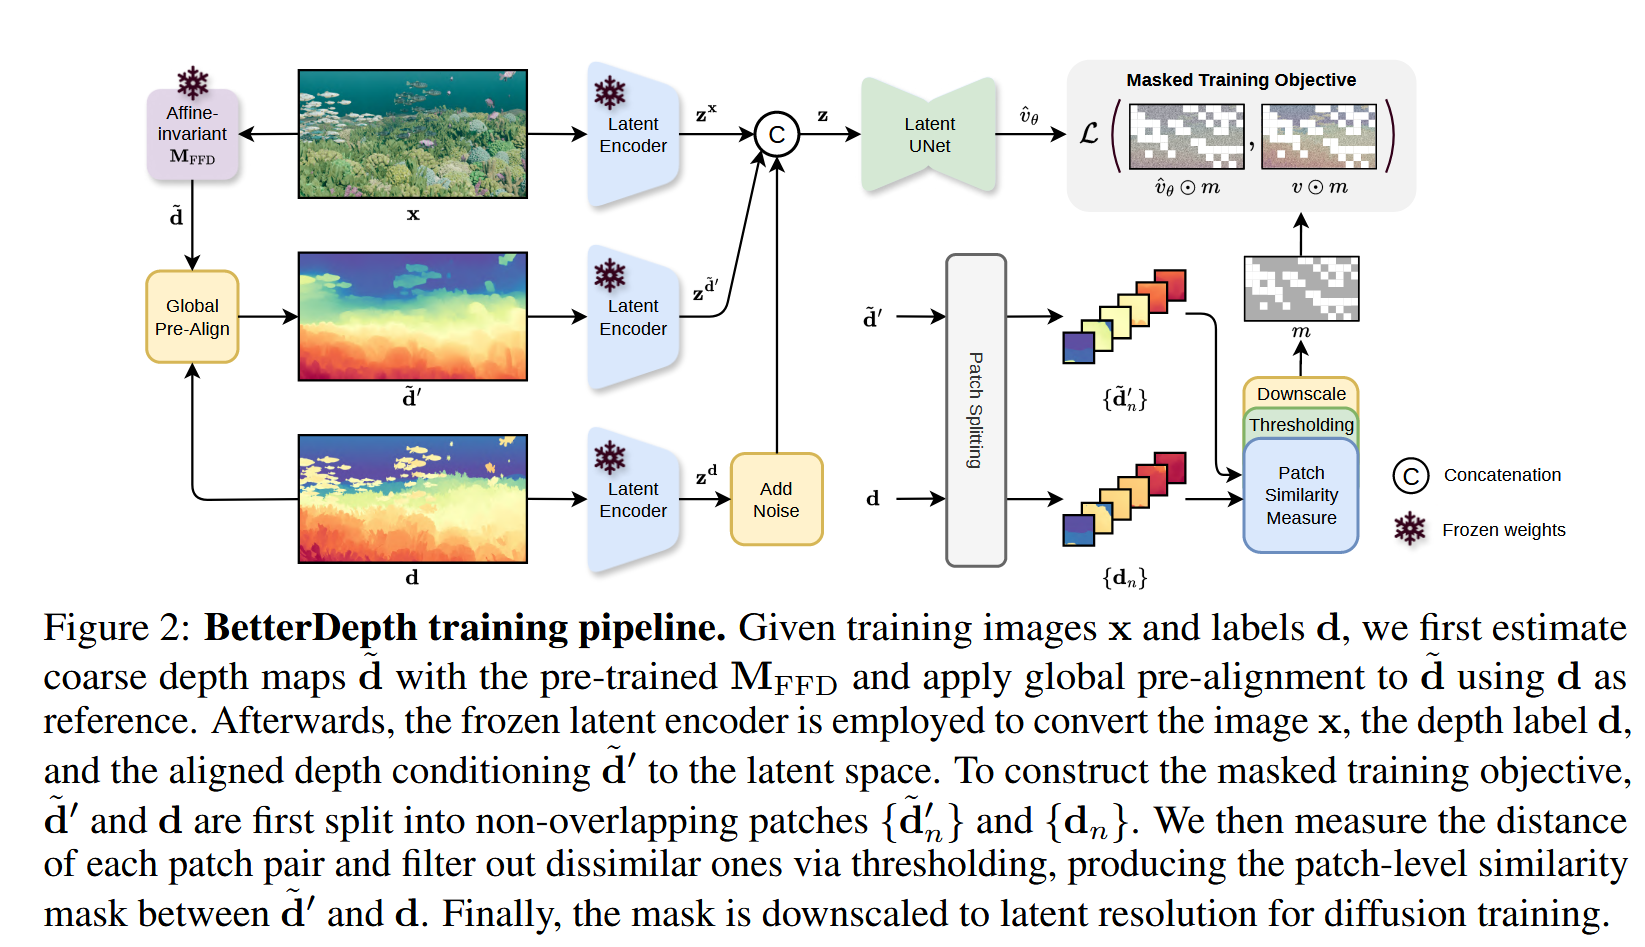
Problem Formulationfeed-forward model: {\cal L}_{\mathrm{M D E}} ( {\bf d}_{i}, {\bf M}_{\mathrm{F F D}} ( {\bf x}_{i} ) ), \tag{1}Diffusion model: {\cal L}_{\mathrm{D M}} \left( \epsilon, {\bf M}_{\mathrm{D M}} \left( {\bf x}_{i}, \mathrm{A d d N o i s e} ( {\bf d}_{i}, \epsilon, t ) \right) \right), \tag{2}Framework Global Pre-Alignment给定预训练仿射不变深度模型$\bf{M}_{FFD}$ 和数据对$\bf{(x, d)} ∈ \bf{D}_{syn}$...
2026-09-01
AerialMetric: Benchmarking and Adapting UAV Monocular Metric Depth Estimation in the Real World
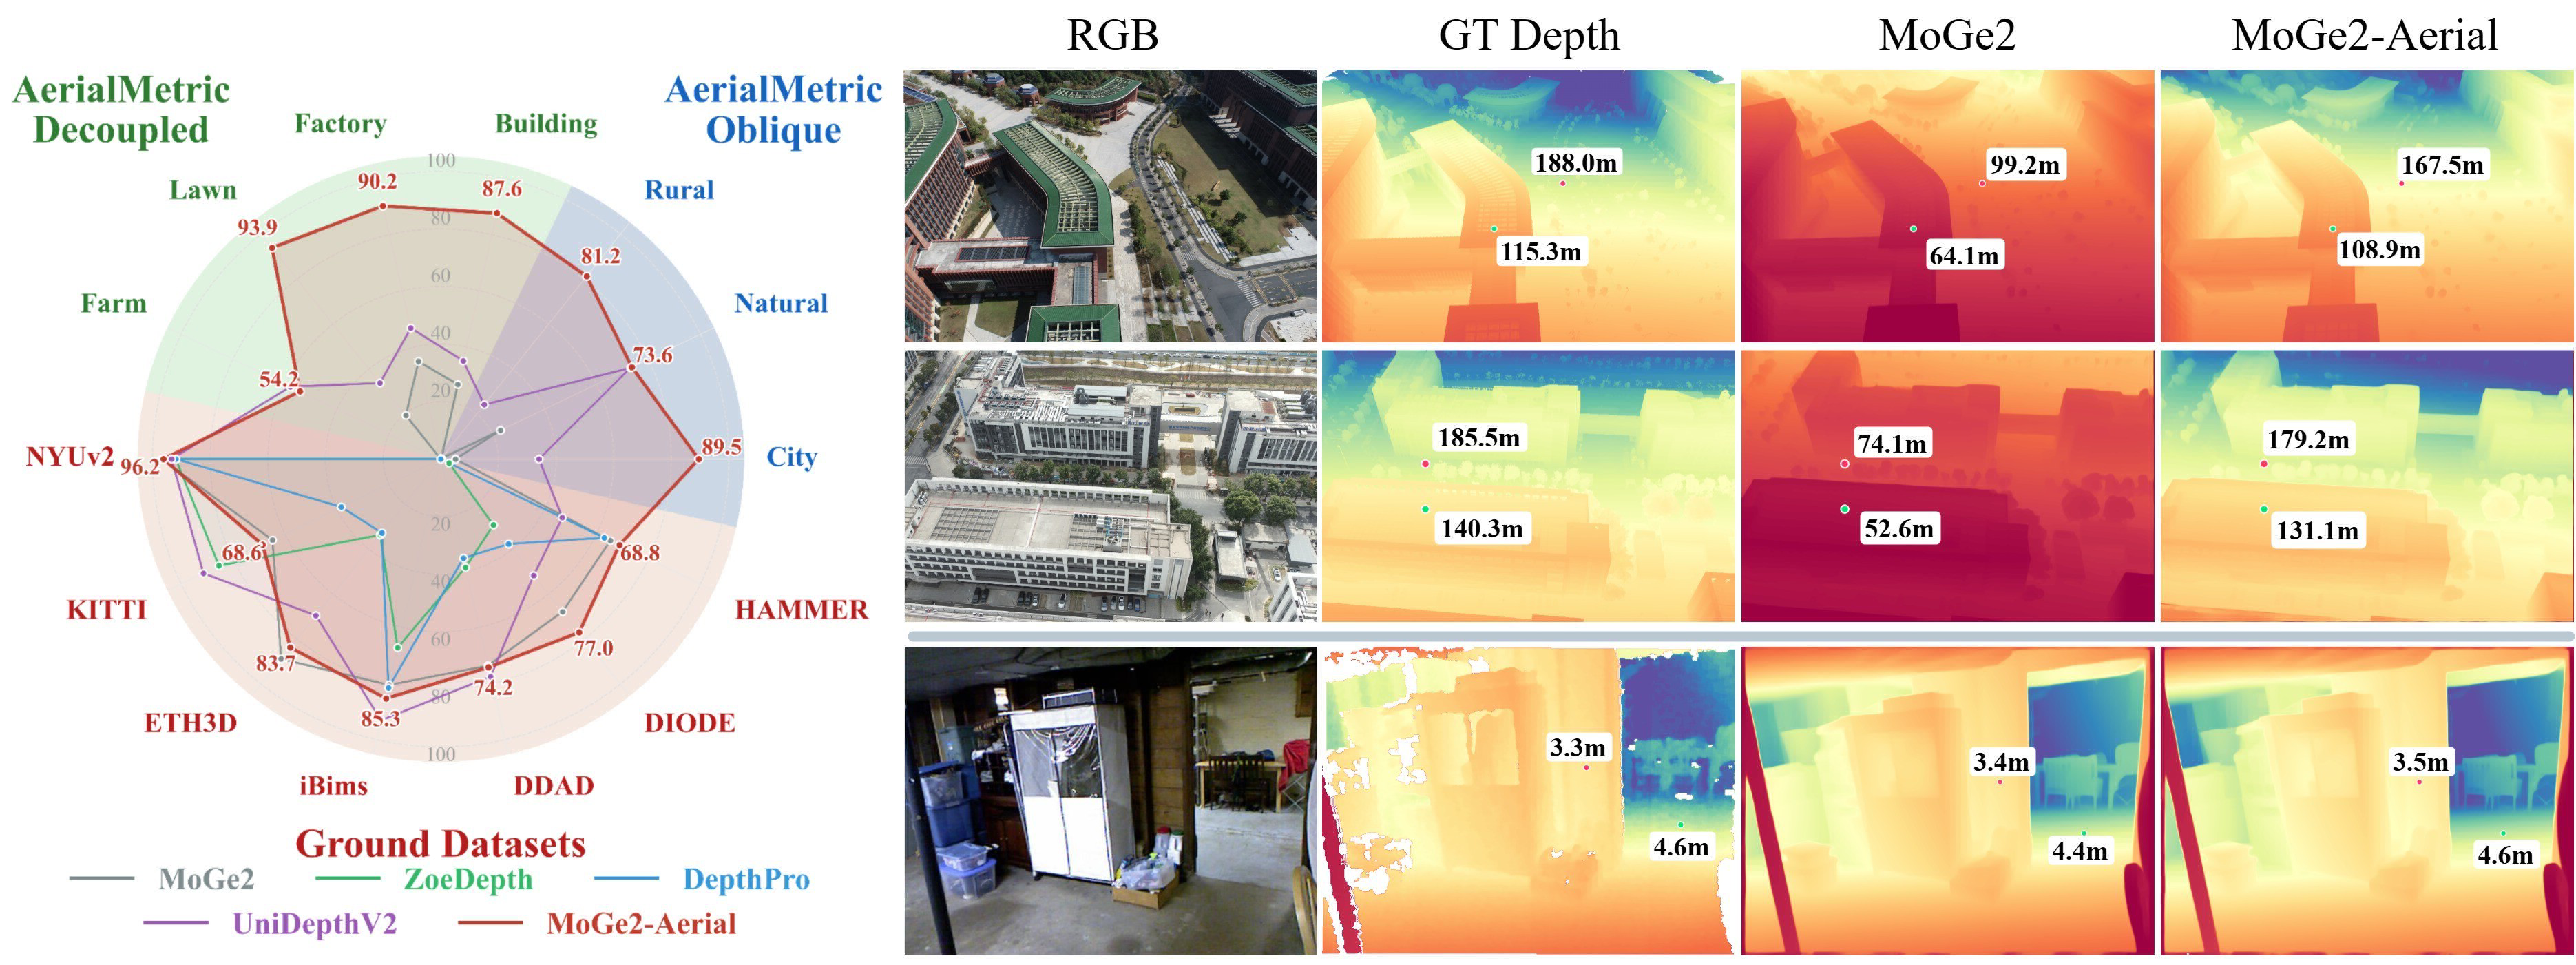
作者:Zhongqiang Song, Guanying Chen, Yuqi Zhang, Yin Zou, Chuanyu Fu, Zhiyuan Yuan, Chuan Huang, Shuguang Cui, Xiaochun Cao 单位:Sun Yat-sen University, Shenzhen Campus;FNii-Shenzhen;SSE, CUHKSZ;SIAS, UESTC 会议:ECCV 2026(arXiv:2606.29716v2,2026) 链接:论文原文;项目主页;代码仓库 这是一篇 benchmark/dataset + adaptation study:论文的主要贡献不是重新设计一个单目深度网络,而是回答一个更基础、也更容易被忽略的问题——现有在地面视角上表现很好的 metric depth 模型,为什么一旦被放到无人机的俯视、斜视和高空场景中就失效,以及我们应该怎样测量、适配和保留它们的能力。 研究动机单目 metric depth estimation 的目标,是从一张 RGB...
2026-07-08
3DShape2VecSet: A 3D Shape Representation for Neural Fields and Generative Diffusion Models
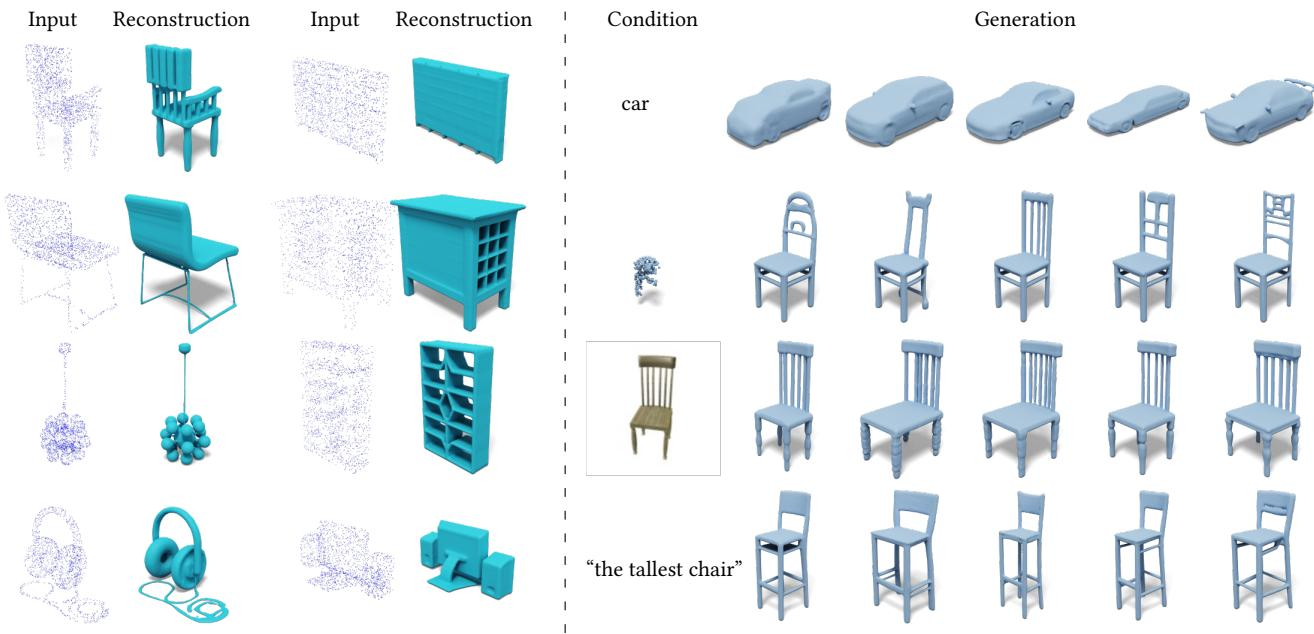
作者:Biao Zhang, Jiapeng Tang, Matthias Nießner, Peter Wonka 单位:KAUST, Technical University of Munich 会议:ACM Transactions on Graphics 42(4), SIGGRAPH 2023 链接:arXiv / Project / Code / DOI 研究动机3DShape2VecSet 讨论的是一个很基础但容易被低估的问题:如果要把扩散模型真正搬到 3D 形状生成里,应该在什么表示空间里扩散? 2D 图像扩散模型可以直接在像素或压缩 latent 上工作,因为图像天然是规则网格。但 3D 形状没有这么统一的表示:voxel 规则但立方级开销太大,point cloud 轻量但缺少连续表面,mesh 结构复杂,neural field 连续且能表达完整表面,却本身像一个无限维函数,不能直接作为扩散模型的固定长度输入。 论文选择的路线是 latent diffusion:先训练一个 shape autoencoder,把 3D 形状压成固定大小...
评论
最新文章