VGGT-Ω
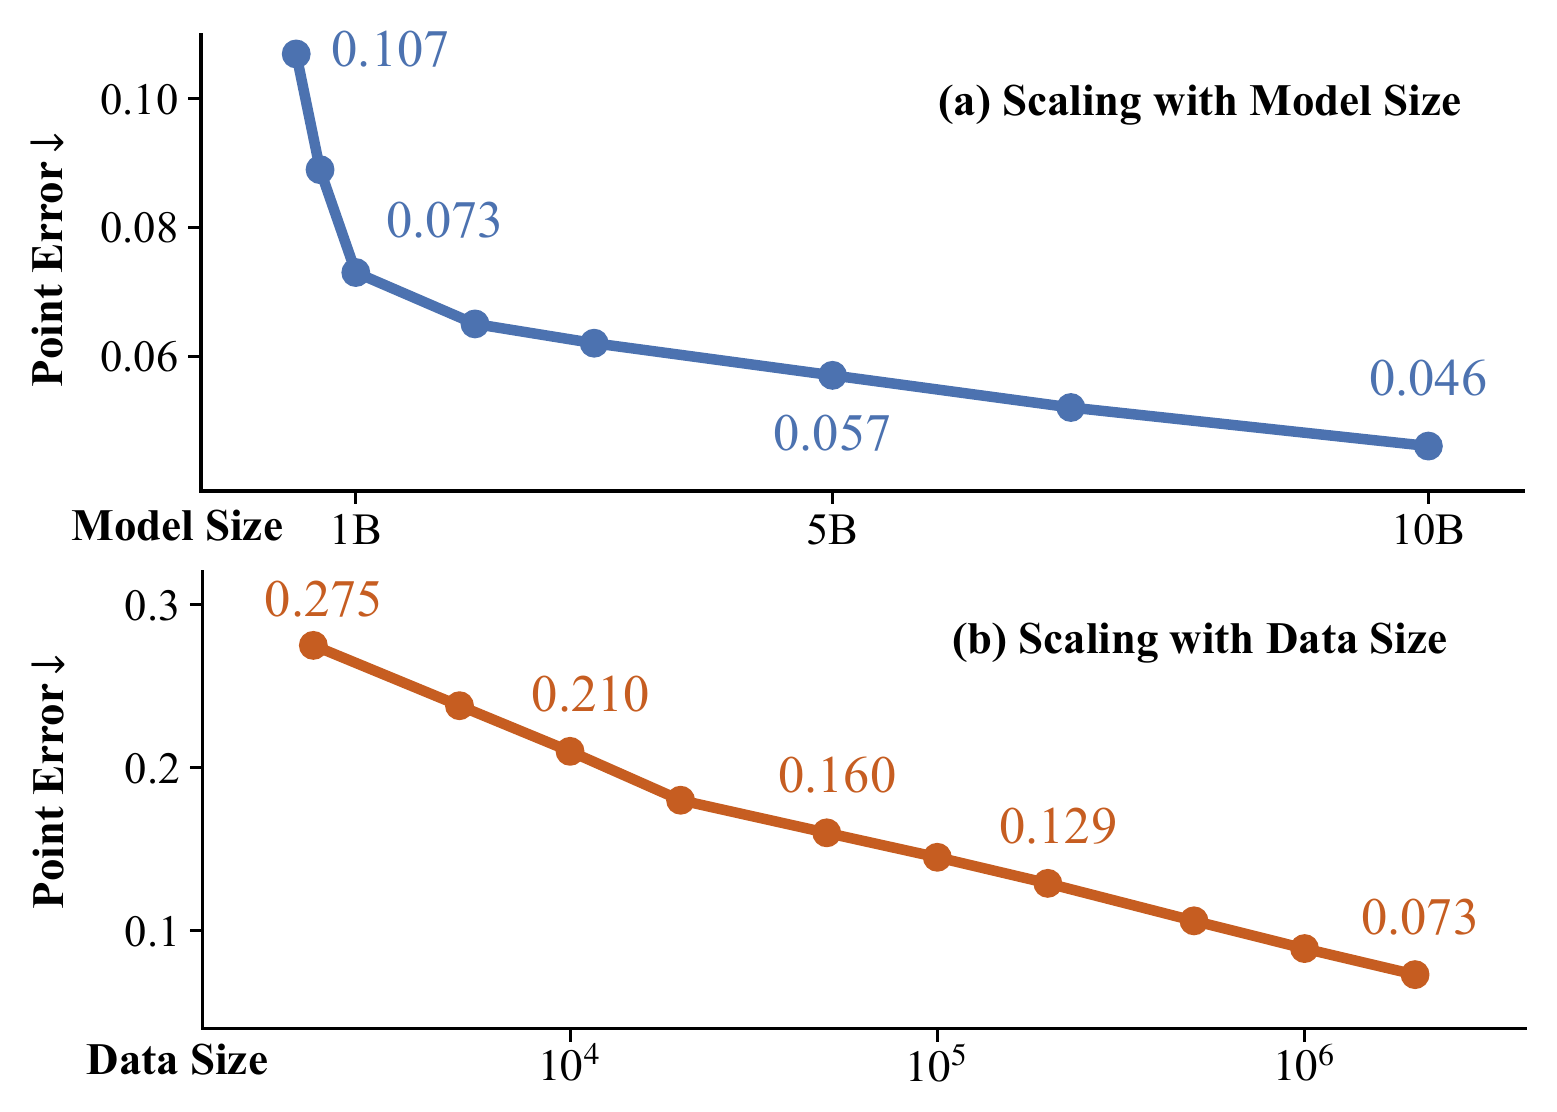
作者:Jianyuan Wang, Minghao Chen, Shangzhan Zhang, Nikita Karaev, Johannes Schönberger, Patrick Labatut, Piotr Bojanowski, David Novotny, Andrea Vedaldi, Christian Rupprecht 单位:Visual Geometry Group, University of Oxford; Meta AI 会议:CVPR 2026 Oral / 2026 Arxiv 链接:https://arxiv.org/abs/2605.15195, Project Page 研究动机VGGT-Ω 这篇文章关心的不是“能不能再把 VGGT 做强一点”,而是一个更底层的问题:前馈式三维重建模型是否也像语言模型、2D 视觉基础模型一样,具有可预期的 scaling law。原始 VGGT 已经证明了 feed-forward reconstruction 可以在很多场景中接近甚至超过传统 SfM/优化式方法,但它仍然有几个限制: 全局...
TokenGS: Decoupling 3D Gaussian Prediction from Pixels with Learnable Tokens
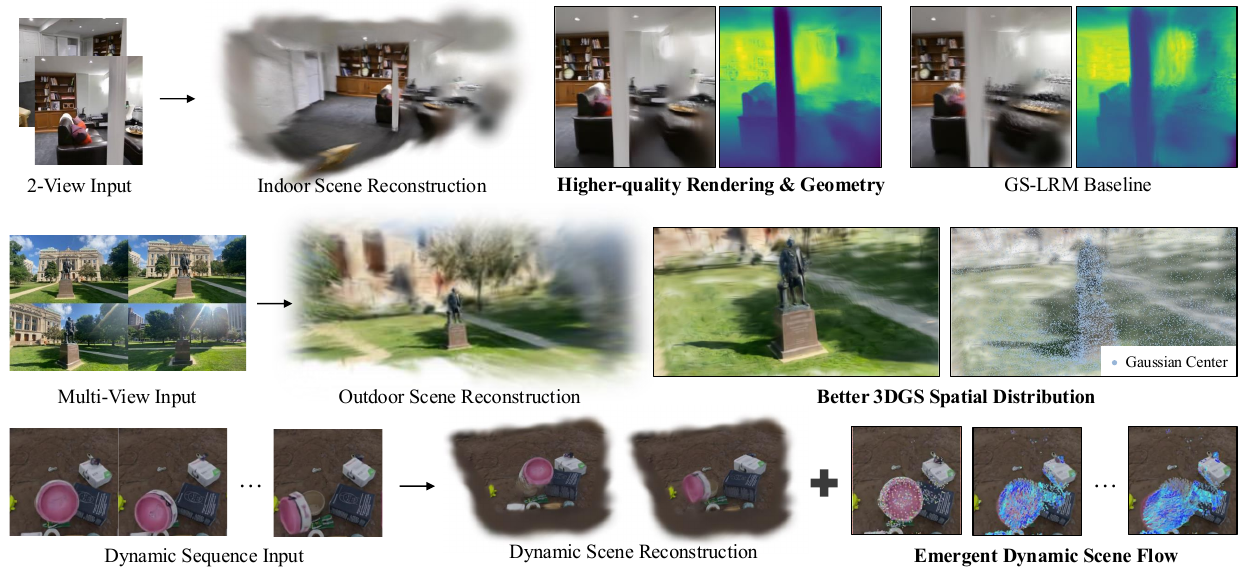
作者:Jiawei Ren, Michal Jan Tyszkiewicz, Jiahui Huang, Zan Gojcic 单位:NVIDIA 会议:CVPR 2026 Highlight(论文为 arXiv v1) 链接:arXiv:2604.15239 · Project Page · Code 研究动机很多前馈式 3DGS 模型按图像像素或 patch 预测高斯,并把中心表示成相机射线上的深度。这种参数化一方面把几何绑在输入像素和相机姿态上:位姿稍有噪声,多视图就可能彼此不一致;另一方面,高斯数量随分辨率和视图数一起增长。论文举例指出,32 张 512×512 图像按像素输出会超过 800 万个基元,其中不少只是重复覆盖同一场景。直接在测试时优化所有高斯参数也可能破坏预训练模型带来的几何先验。 TokenGS 保留前馈推理,但改变输出端的“单位”:不再为像素分配高斯,而是让一组 learnable Gaussian tokens 直接回归共享场景坐标中的三维中心,再由每个 token...
UniQueR: Unified Query-based Feedforward 3D Reconstruction
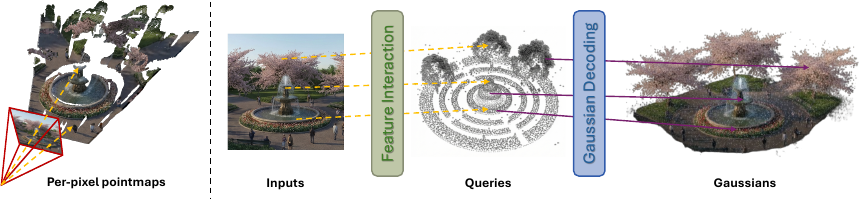
作者:Chensheng Peng, Quentin Herau, Jiezhi Yang, Yichen Xie, Yihan Hu, Wenzhao Zheng, Matthew Strong, Masayoshi Tomizuka, Wei Zhan 单位:Applied Intuition, University of California, Berkeley, Stanford University 会议:ECCV 2026(收录;论文为 arXiv v2) 链接:arXiv:2603.22851 · Project Page · ECCV 2026 Accepted Papers 研究动机前馈式三维重建已经能从少量图像一次性预测点图或 3D Gaussian Splatting(3DGS),但常见做法仍是“每个像素对应一批三维基元”:几何沿相机射线组织,天然只覆盖输入图像看见的表面。换到遮挡区域或输入视角之外时,模型缺少主动分配几何的自由度,容易留下空洞。UniQueR...
$R^3$: 3D Reconstruction via Relative Regression
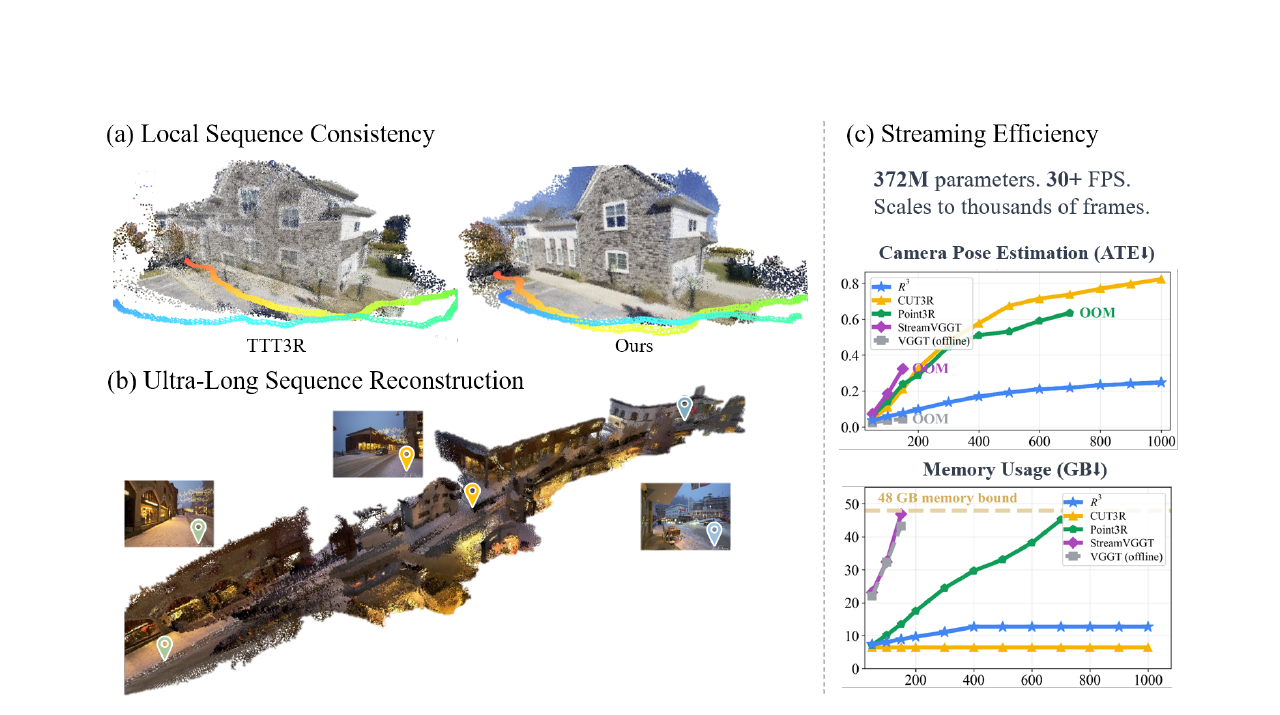
作者:Congrong Xu, Huachen Gao, Xingyu Chen, Yuliang Xiu, Jun Gao, Anpei Chen 单位:University of Michigan、Westlake University、NVIDIA 会议:2026 Arxiv(v2) 链接:arXiv:2605.26519 · Project Page · Code 研究动机从一段单目视频恢复三维结构,通常要同时得到每帧深度、相机内参和相机位姿。近来的 feed-forward...
MonoInstance: Enhancing Monocular Priors via Multi-view Instance Alignment for Neural Rendering and Reconstruction
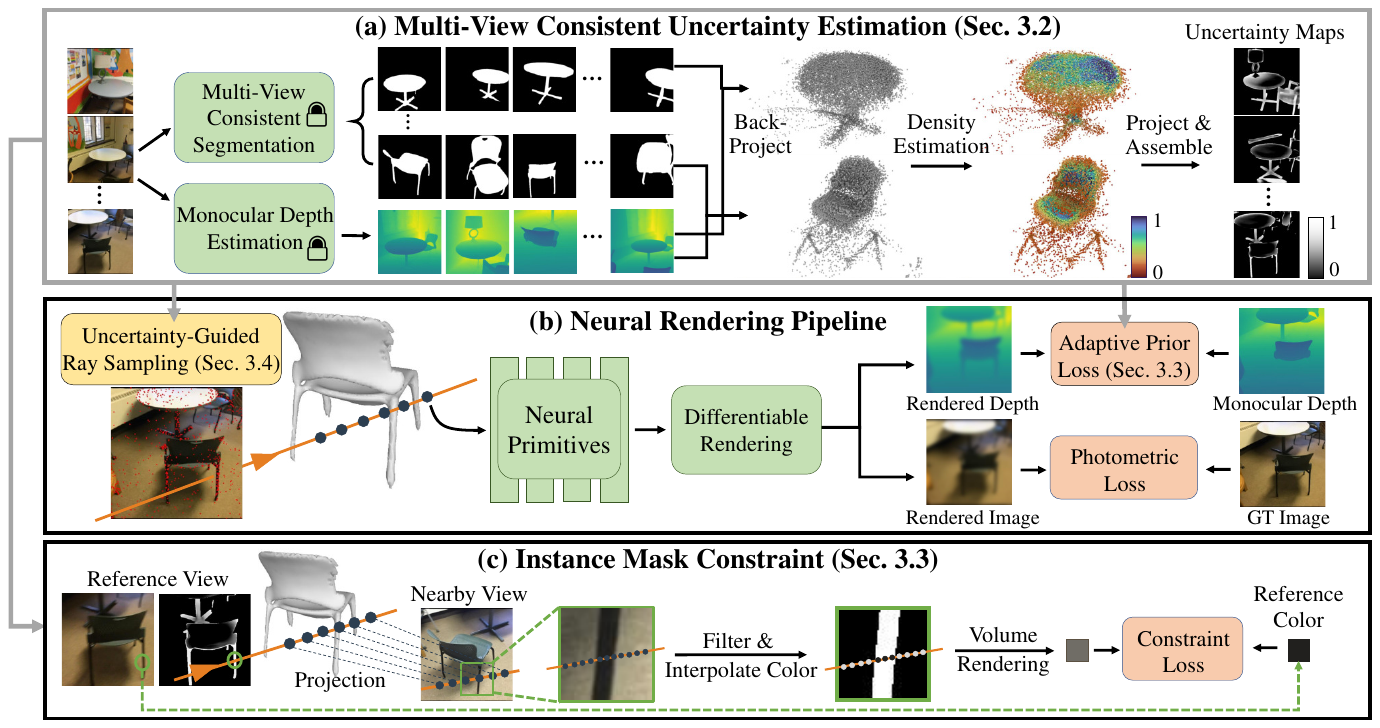
作者:Wenyuan Zhang, Yixiao Yang, Han Huang, Liang Han, Kanle Shi, Yu-Shen Liu, Zhizhong Han 单位:清华大学软件学院、快手科技、Wayne State University 会议:CVPR 2025 链接:CVF Open Access · Project Page 研究动机NeRF、3D Gaussian Splatting(3DGS)等多视角神经表示通常通过颜色重建损失学习场景。颜色的多视角一致性能够让渲染结果看起来合理,却不能保证几何一定正确,尤其是在纹理弱、遮挡多或存在 shape-radiance ambiguity 的区域。于是,MonoSDF 等方法会加入单目深度和法向先验,帮助优化器恢复更完整的表面。 问题在于,单目先验本身也不完美:模型存在域差异,且每张 RGB 图像被独立预测,同一个椅腿、灯架或建筑边缘在不同视角下可能对应不同的 3D...
Scalix: Uncertainty-Aware Scale-Consistent Monocular SLAM
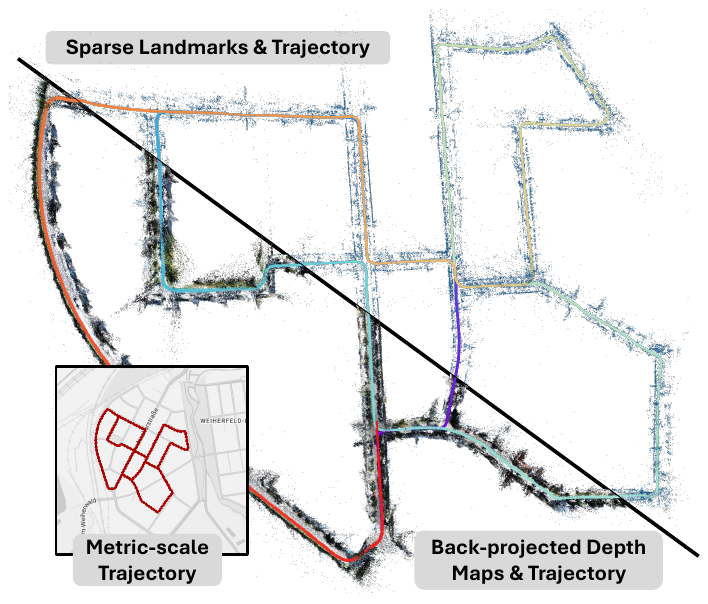
作者:Sebastian Barbas Laina, Tianyi Zhang, Panagiotis Petropoulakis, Simon Schaefer, Simon Boche, Jaehyung Jung, Cedric Le Gentil, Stefan Leutenegger 单位:当前 arXiv v1 未列出作者单位 会议:2026 Arxiv 链接:arXiv:2608.17553 研究动机单目 SLAM 只使用一台相机,硬件简单、信息密度高,但它天生只能恢复 up-to-scale 的几何:相机轨迹和地图整体乘上任意一个尺度,图像重投影误差仍然可以保持不变。多相机、激光雷达或视觉惯性组合能够提供尺度,却带来了外参标定、传感器同步和硬件体积问题。对于小型无人机等平台,视觉惯性系统在匀速运动时也可能失去可观测尺度。 近年来的单目 metric depth 模型可以从单帧 RGB 估计带有米制意义的深度,为单目 SLAM 提供了很有价值的先验。然而,这类预测在连续帧之间往往存在噪声、尺度漂移和时间不一致:如果直接把每一帧深度当作真值,SLAM...
AerialMetric: Benchmarking and Adapting UAV Monocular Metric Depth Estimation in the Real World
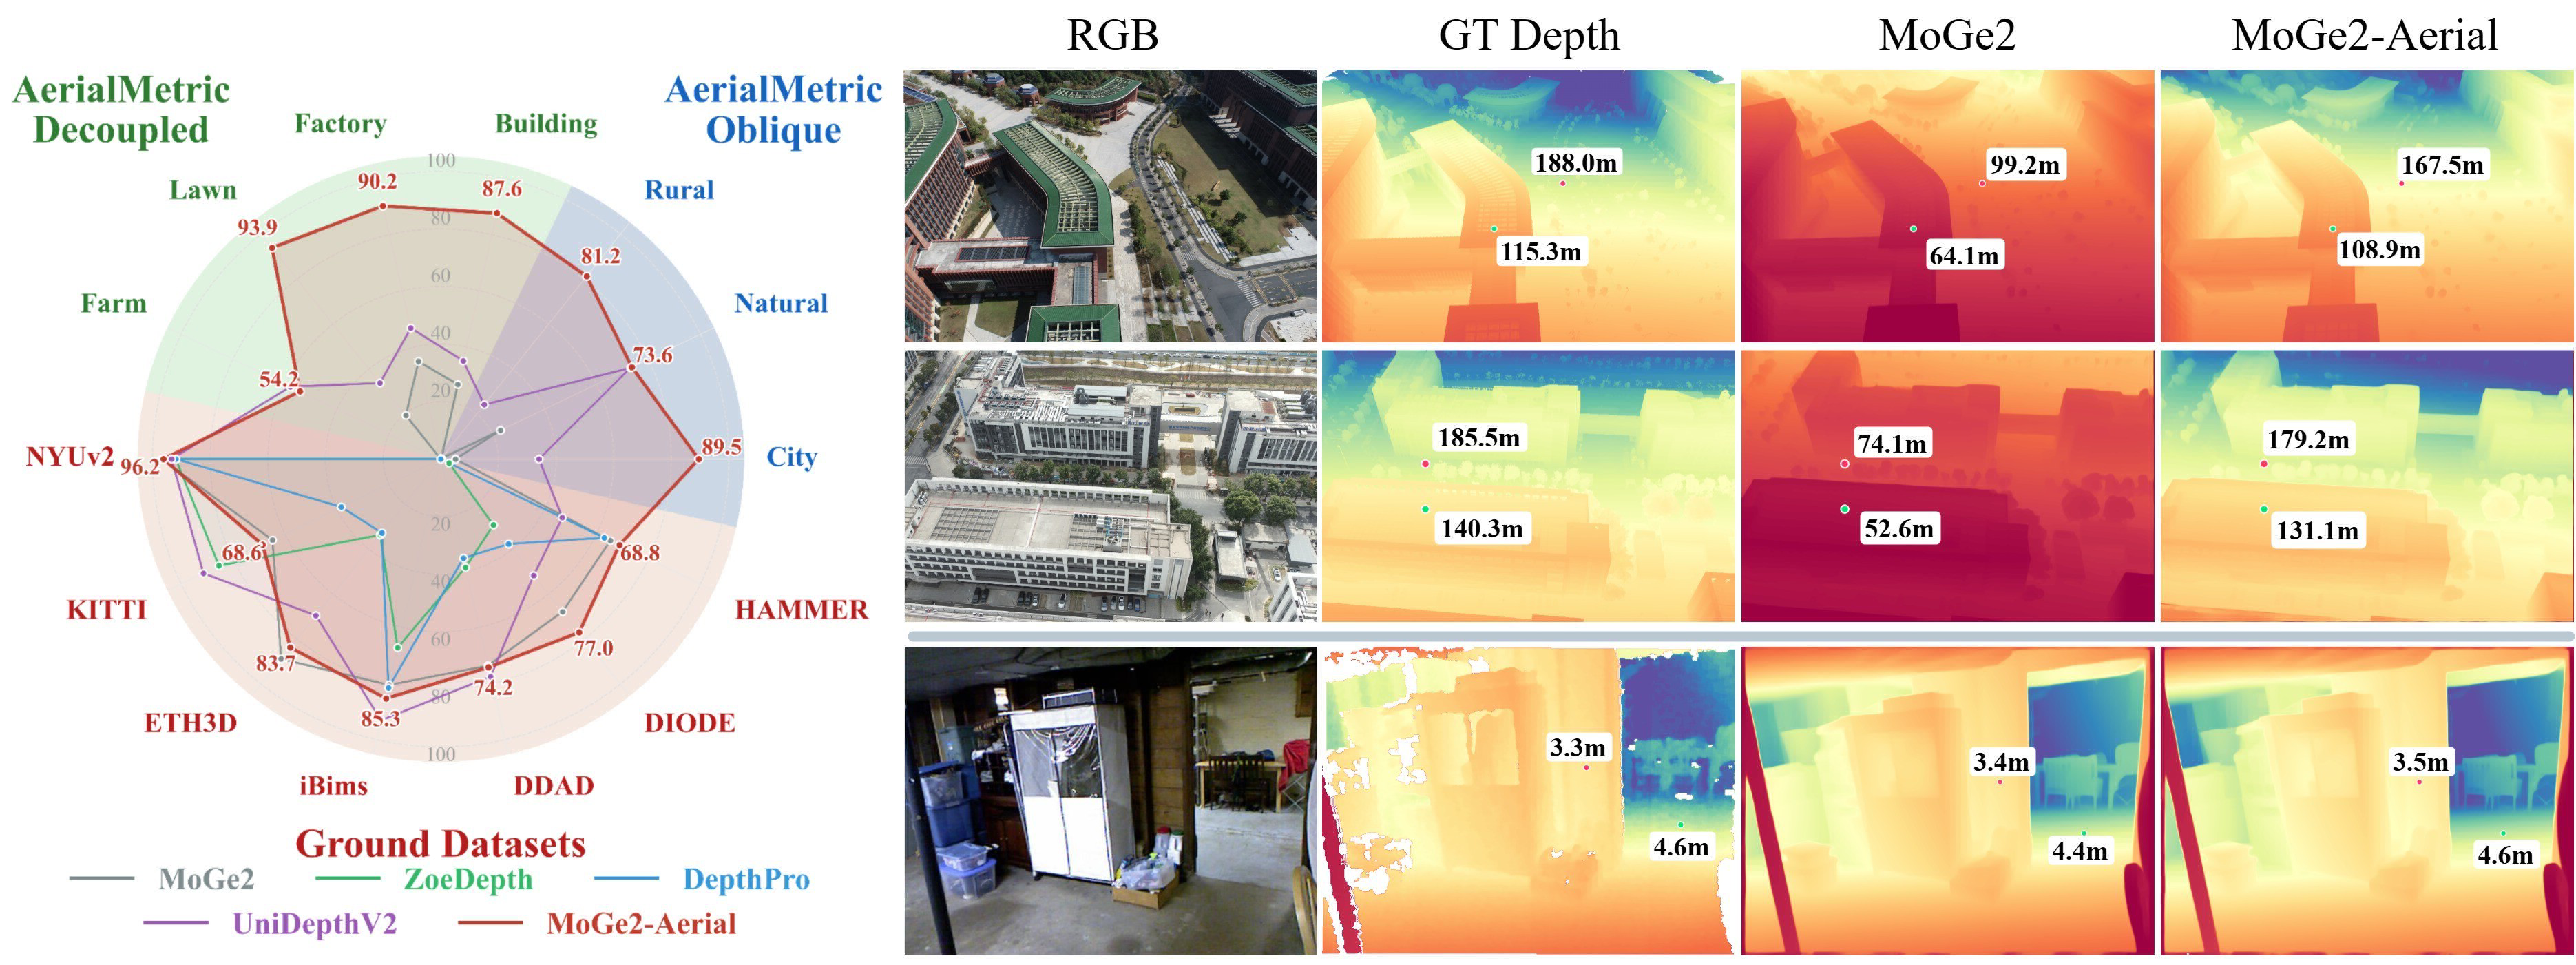
作者:Zhongqiang Song, Guanying Chen, Yuqi Zhang, Yin Zou, Chuanyu Fu, Zhiyuan Yuan, Chuan Huang, Shuguang Cui, Xiaochun Cao 单位:Sun Yat-sen University, Shenzhen Campus;FNii-Shenzhen;SSE, CUHKSZ;SIAS, UESTC 会议:ECCV 2026(arXiv:2606.29716v2,2026) 链接:论文原文;项目主页;代码仓库 这是一篇 benchmark/dataset + adaptation study:论文的主要贡献不是重新设计一个单目深度网络,而是回答一个更基础、也更容易被忽略的问题——现有在地面视角上表现很好的 metric depth 模型,为什么一旦被放到无人机的俯视、斜视和高空场景中就失效,以及我们应该怎样测量、适配和保留它们的能力。 研究动机单目 metric depth estimation 的目标,是从一张 RGB...
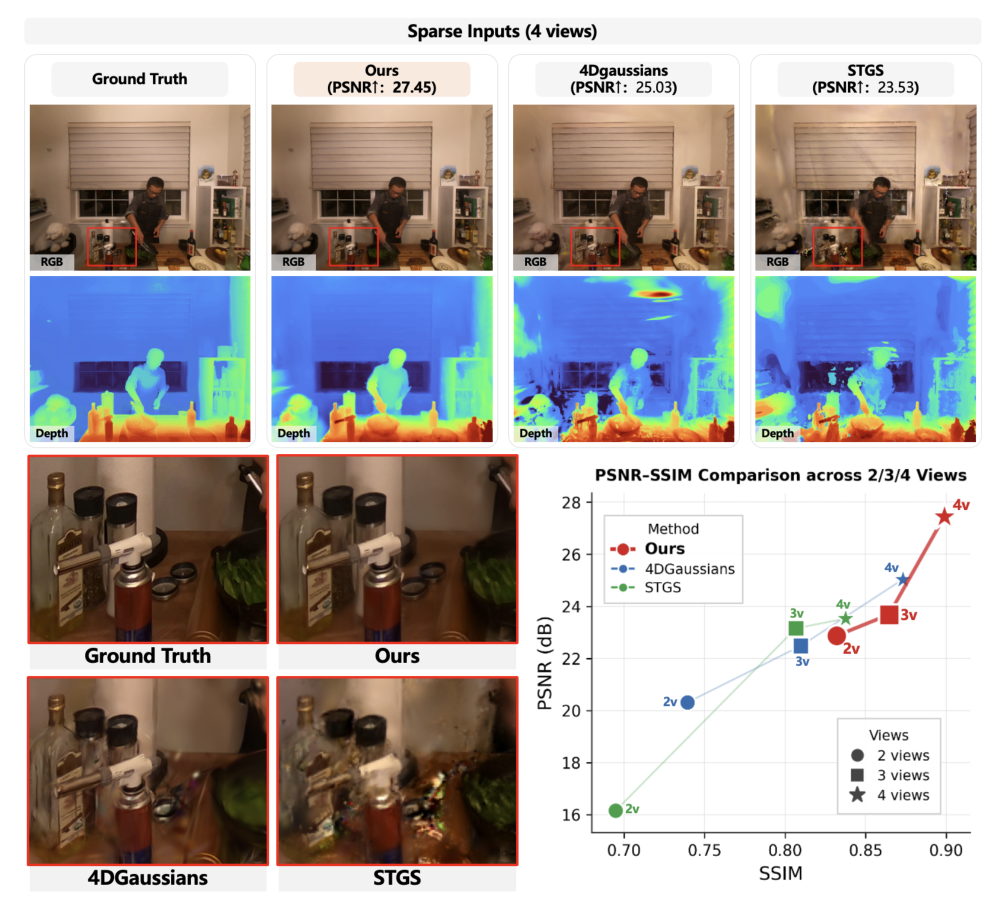
D^2-4DGS: Dual-Depth Guided Sparse-Camera 4D Gaussian Splatting
作者: Jijian Zhao 单位: Huazhong University of Science and Technology 会议: 2026 Arxiv 链接: arXiv 研究动机Dynamic 4DGS 通常依赖密集、同步的多相机视频。相机数量减少以后,RGB supervision 很难唯一确定动态场景的 3D geometry:错误位置的 Gaussians 仍然可能解释有限 training views,最终产生 missing structures、foreground/background blending 和 floating primitives。 引入 depth prior 是自然选择,但 D²-4DGS 认为 单一 depth source 都不够: Monocular depth:coverage 稠密,但 scale ambiguous,而且存在局部 bias; Multi-view geometric depth:与 reconstruction coordinate system 一致、几何可靠性更高,但在...
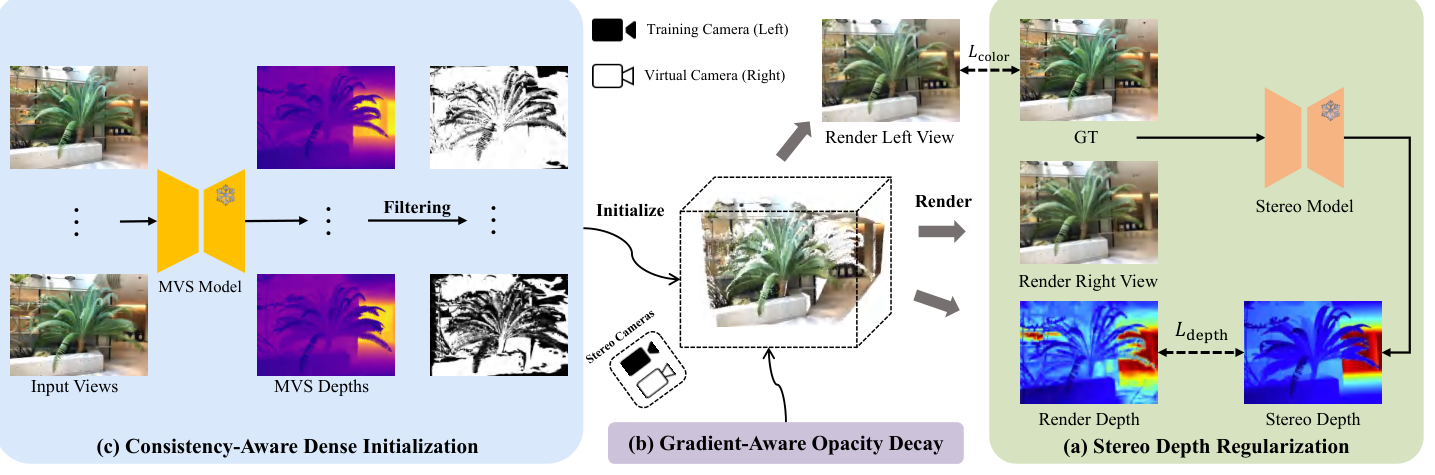
StereoGS: Sparse-View 3D Gaussian Splatting via Stereo Priors
作者: Wenhao Yuan, Yiyuan Ge, Deli Cai 单位: South China University of Technology 会议: ECCV 2026 链接: arXiv | Project | Code 研究动机Sparse-view 3DGS 的根本困难不是 renderer 不够强,而是 几何约束太弱。只有少量训练视角时,很多错误的 Gaussian geometry 仍然可以很好地拟合训练 RGB,因此优化很容易出现 overfitting、floaters、错误表面和 novel-view artifacts。 已有方法常用 monocular depth prior 缓解这个问题,但 StereoGS 认为 MDE 在这里有两个天然缺陷: scale ambiguity:单目 depth 的尺度与 3DGS 世界坐标不天然一致; cross-view inconsistency:每个视角独立推理,同一真实 3D point 在不同图像中的 depth 可能不一致。 即使先用 MVS 获得一个更好的...
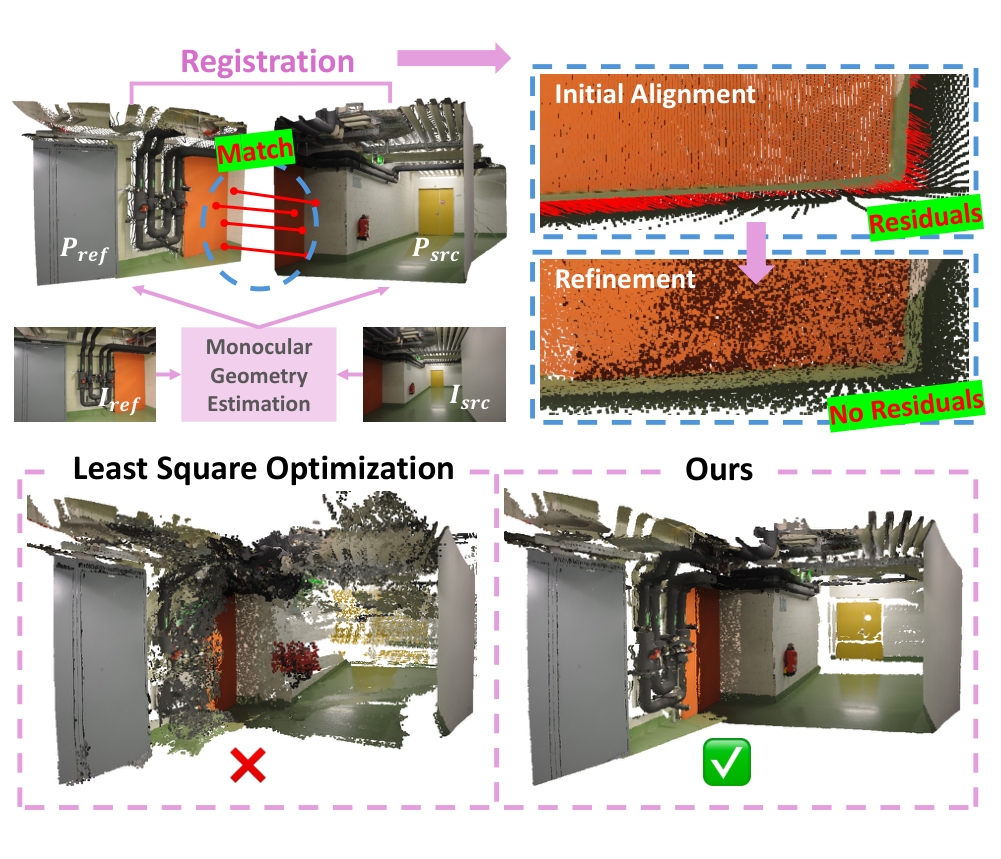
MoRe: Monocular Geometry Refinement via Graph Optimization for Cross-View Consistency
作者: Dongki Jung, Jaehoon Choi, Yonghan Lee, Sungmin Eum, Heesung Kwon, Dinesh Manocha 单位: University of Maryland, College Park;DEVCOM Army Research Laboratory 会议: WACV 2026 链接: arXiv | CVF Paper 研究动机MoRe 讨论的是一个非常直接的下游问题:单目 3D foundation model 单帧预测很好,但把多个视角的 point map 放到同一个世界坐标系后,为什么仍然对不齐? 以 MoGe 为代表的 monocular geometry model 可以预测细节丰富的 point map 和 normal,但每一帧都是独立推理。即使 camera pose 已知,把各视角 point map 变换到共同坐标系后,仍然会受到 monocular affine...
最新文章