MonoInstance: Enhancing Monocular Priors via Multi-view Instance Alignment for Neural Rendering and Reconstruction
作者:Wenyuan Zhang, Yixiao Yang, Han Huang, Liang Han, Kanle Shi, Yu-Shen Liu, Zhizhong Han
单位:清华大学软件学院、快手科技、Wayne State University
会议:CVPR 2025
链接:CVF Open Access · Project Page
研究动机
NeRF、3D Gaussian Splatting(3DGS)等多视角神经表示通常通过颜色重建损失学习场景。颜色的多视角一致性能够让渲染结果看起来合理,却不能保证几何一定正确,尤其是在纹理弱、遮挡多或存在 shape-radiance ambiguity 的区域。于是,MonoSDF 等方法会加入单目深度和法向先验,帮助优化器恢复更完整的表面。
问题在于,单目先验本身也不完美:模型存在域差异,且每张 RGB 图像被独立预测,同一个椅腿、灯架或建筑边缘在不同视角下可能对应不同的 3D 深度。现有做法通常把整张单目深度图一视同仁地当成监督,错误区域反而会把神经表面拉向错误位置;一些不确定性方法通过相邻视图投影估计误差,又容易受到遮挡影响,或者把不确定性分支和渲染质量绑定在一起。
MonoInstance 的关键观察是:同一个物体在多视角中应该落到同一个 3D 实例表面。把实例深度对齐、回投影并融合成点云后,可靠深度会在真实表面附近形成高密度点,错误深度则沿不同视线分散。于是,点云邻域密度可以成为一个与渲染网络解耦的单目先验不确定性度量。
核心方法
论文以 NeRF 重建为主线说明方法,但强调 MonoInstance 可以作为通用策略接入多种多视角神经渲染与重建框架。整体流程如下:
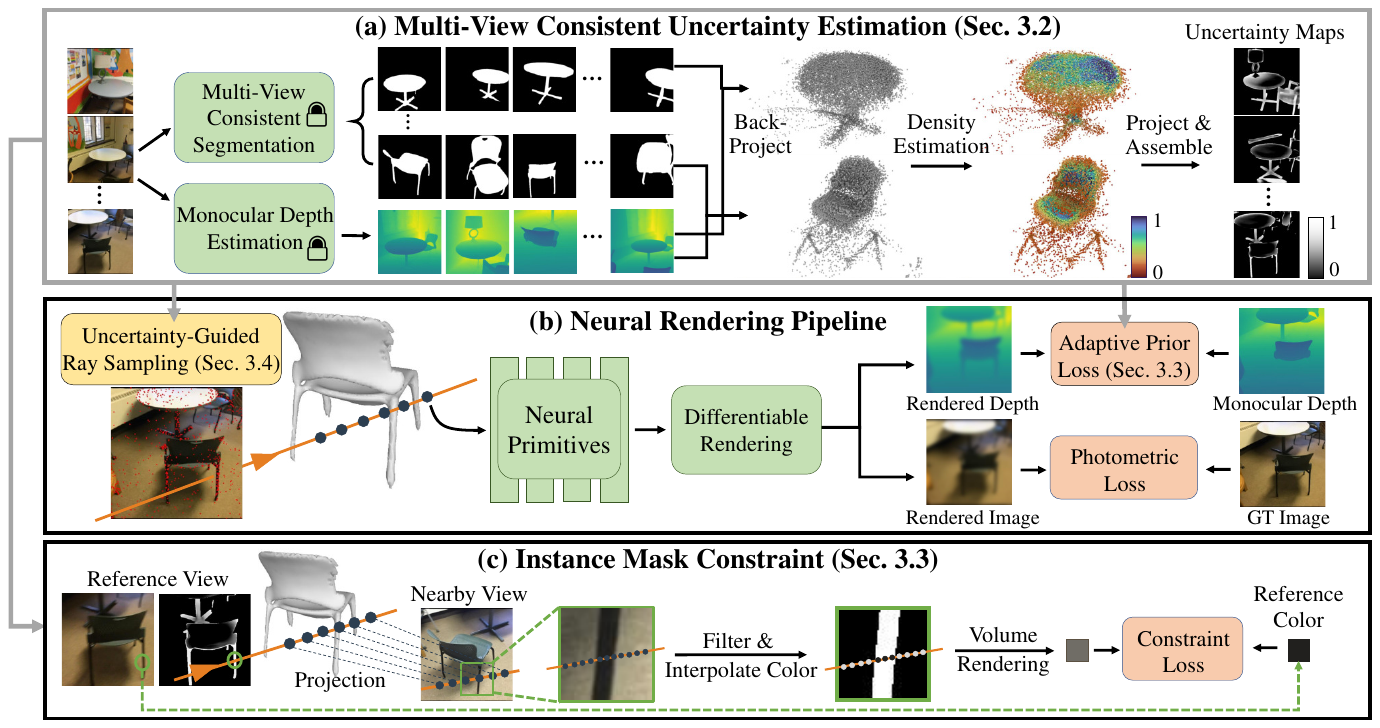
图 1:MonoInstance 总览。先对多视角实例进行一致分组并估计单目深度,再把同一实例的深度回投影到统一 3D 空间,根据局部点密度得到不确定性图,最后用它调节先验损失、射线采样和实例掩码约束。
1. 从多视角实例构造统一的 3D 证据
给定带位姿的图像集合 ${Ij}{j=1}^{N}$ 和对应单目深度 ${Dj}{j=1}^{N}$,目标是估计每个视图的不确定性图 ${Uj}{j=1}^{N}$。关键是“按实例计算”,而不是把不同物体的点混在一起。
论文首先用实例分割模型得到每张图像中的对象,再把来自不同视图的实例节点连接成图:如果两个实例的回投影深度点云在 Chamfer Distance 意义下足够接近,就连一条边;随后使用图聚类获得跨视图一致的实例簇。对于室内场景,作者假设纹理弱的墙面、地面和天花板上的单目先验通常更可靠,因此用 GroundedSAM 识别背景实例并把其不确定性置零。
2. 用点密度反推单目深度不确定性
对于一个跨视图实例,MonoInstance 先把各视角的单目深度通过 scale-shift invariant affine 对齐到渲染深度,再回投影到世界坐标系,形成融合点云。高质量深度会让同一表面上的点聚集,错误深度则会形成较分散、具有方向性的点分布。方法示意如下:
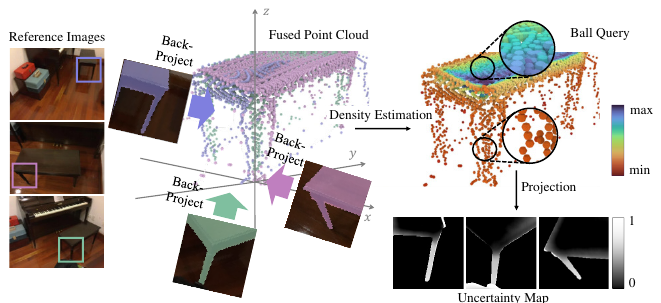
图 2:不确定性估计。椅腿这类视角不一致的区域会形成低密度、分散的点云,因此被标成高不确定性;椅面等一致区域的点更密集,对应低不确定性。
为避免视图数量影响密度,论文把融合点云固定下采样到 30,000 个点。对实例内每个回投影点 $p(\mathbf u)$ 做 ball query,邻域半径定义为:
其中,$P$ 是下采样后的融合点云,$B_{\mathrm{opt}}(P)$ 是其最小有向包围盒,$\operatorname{Vol}$ 表示包围盒体积。得到邻域密度 $d(p(\mathbf u))$ 后,在该实例的所有查询点中归一化:
因此,$U_i$ 越大,表示该像素的单目深度在多视角 3D 中越不一致。该不确定性来自跨视图几何证据,而不是依赖当前渲染网络是否已经学好。
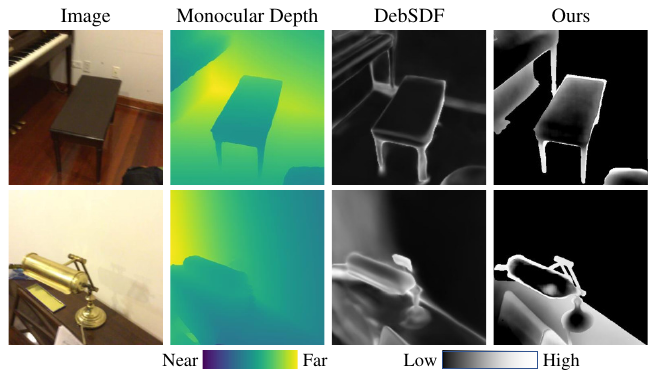
图 3:DebSDF 与 MonoInstance 的不确定性图对比。MonoInstance 的响应更尖锐,能更准确地覆盖椅腿、灯架等细粒度结构。
3. 自适应先验损失与实例掩码约束
得到不确定性图后,论文采用三种互补策略:
- 自适应深度先验。将不确定性作为单目深度与渲染深度差异的权重,降低错误单目监督对表面的牵引;可靠区域保留较强的深度约束,高不确定性区域则更多依赖颜色和实例约束。
- 不确定性引导的射线采样。对实例按面积分配采样预算,再使用作为第 $i$ 个视图的采样概率。额外的 0.05 保证不确定性为零的区域仍有机会被采样。
- 实例掩码约束。高不确定性区域通常包含复杂结构,单靠 photometric loss 不够。对于参考视图中一条射线上的采样点,将它们投影到邻近视图,只保留落在同一实例掩码内的点,再用邻近视图的插值颜色和预测 opacity 进行体渲染:
其中 $\mathbf 1_j$ 表示投影点是否落在邻近视图的对应实例掩码中。将 $\hat C_n^{\mathrm{sil}}$ 与参考视图颜色比较,相当于要求被保留的采样点在多视角中共同解释同一物体表面。
4. 两阶段训练目标
训练分为两阶段。第一阶段对单目深度先验进行均匀使用,先得到一个粗糙的场景表示;随后从所有视角渲染低分辨率深度,把单目深度对齐到同一尺度,并计算每个实例的不确定性。第二阶段再把不确定性图接入自适应深度损失、引导采样和实例掩码约束。
总体损失写成:
其中,$\mathcal L{\mathrm{color}}$ 是颜色重建损失,$\mathcal L{\mathrm{eik}}$ 是 Eikonal 正则,$\mathcal L_{\mathrm{sil}}$ 是实例掩码约束,$\mathcal L_d$ 是自适应深度先验损失,$\mathcal L_n$ 是可选的自适应法向损失。实验中的权重为 $\lambda_1=0.1,\lambda_2=0.4,\lambda_3=0.5,\lambda_4=0.05$。
数据集
论文覆盖三类多视角任务,并在不同单目先验上做了额外比较:
- 密集视图 3D 重建:ScanNet 选取 4 个场景,Replica 使用全部 8 个场景;每个场景有约 200–400 个密集视角观测。基线包括 MonoSDF、HybridNeRF、H2O-SDF、DebSDF 和 RS-Recon。
- 稀疏视图 3D 重建:DTU 使用 15 个场景,每个场景只有 3 个视角,且视角之间重叠较小。这里先把场景分成物体和背景,只对中心物体计算实例不确定性。
- 稀疏视图新视角合成:LLFF 包含 8 个前向观察的真实场景,使用 3 个输入视图,并按论文设置把输入分辨率缩小为原来的八分之一;比较 NeRF 和 3DGS 系列方法。
单目先验的选择实验覆盖 Omnidata、Metric3D v2 和 GeoWizard,正文实验以 Metric3D v2 作为主要先验。重建任务使用 Acc、Comp、Precision、Recall、F-score、Chamfer Distance(CD)和 Normal Consistency(N.C.);LLFF 新视角合成使用 PSNR、SSIM 和 LPIPS。
算力
论文正文未明确报告训练 GPU、batch size、每个场景的训练时间或端到端吞吐率,因此这些配置不能从主文可靠推断。可以确认的实现信息是:方法建立在 MonoSDF 代码之上,密集重建使用上述四个损失权重;单目法向与深度来自同一个基础模型,因此复用同一张不确定性图。论文还说明,邻近视图按观测角度差选择;更多工程细节放在 supplementary materials 和官方代码仓库中。
实验结果
密集视图重建:先验增强带来更完整的薄结构
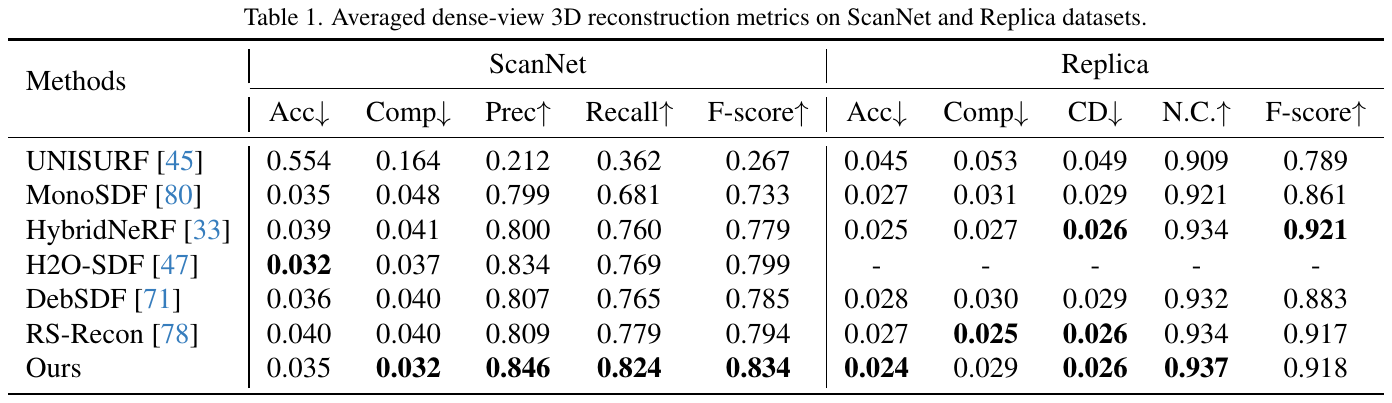
表 1:ScanNet 与 Replica 上的密集视图 3D 重建指标。
在 ScanNet 上,MonoInstance 的 Acc、Comp、Precision、Recall 和 F-score 分别为 0.035、0.032、0.846、0.824 和 0.834;其中 Comp、Precision、Recall 和 F-score 优于表中基线。Replica 上的 Acc 为 0.024,Comp 为 0.029,CD 为 0.026,N.C. 为 0.937,F-score 为 0.918;它在 Acc 和 N.C. 上取得最佳值,CD 与部分方法并列最佳。
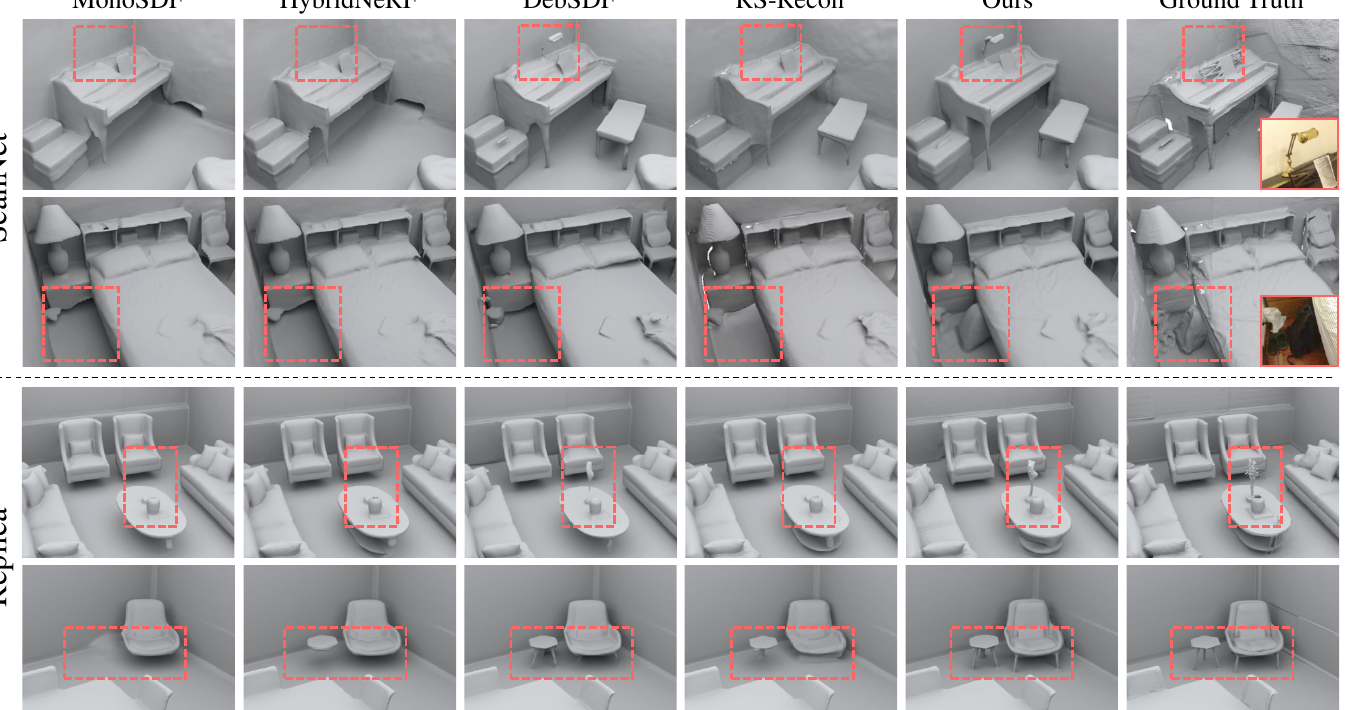
图 4:ScanNet 与 Replica 的定性重建。相比基线,MonoInstance 对钢琴上的灯、茶几上的花和椅腿等细小结构更完整。
稀疏视图重建:不把每个单目像素都当真值
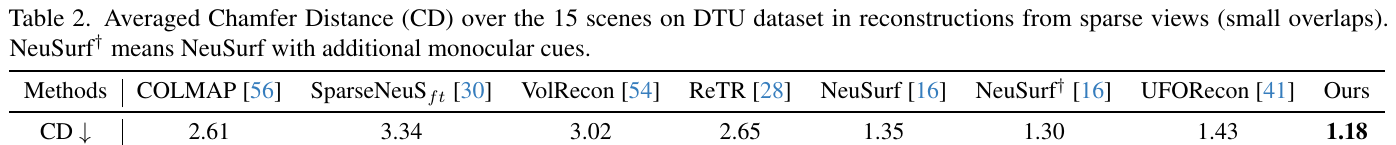
表 2:DTU 15 个场景上的平均 Chamfer Distance,越低越好。
DTU 上 MonoInstance 的 CD 为 1.18,优于 COLMAP 的 2.61、NeuSurf 的 1.35、加入均匀单目 cues 的 NeuSurf† 的 1.30,以及 UFORecon 的 1.43。这个比较很好地说明了论文的出发点:把单目深度不加区分地应用到所有像素,并不会稳定提升 NeuSurf;先找出高不确定性区域,再有选择地使用几何和实例约束才更有效。
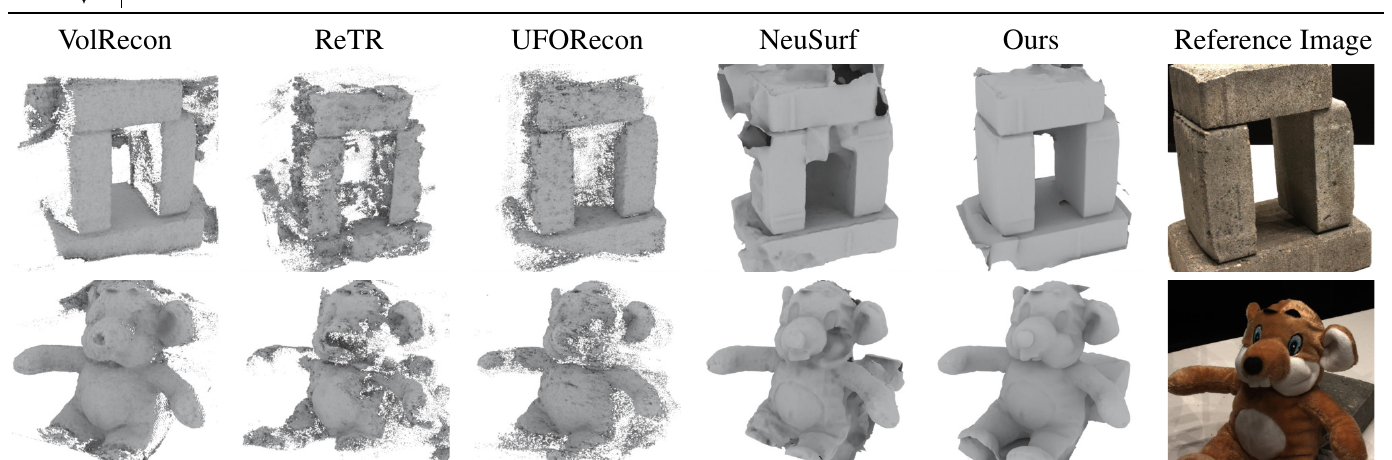
图 5:DTU 小重叠稀疏输入下的定性重建。MonoInstance 输出的物体表面更连续,点云噪声也更少。
稀疏新视角合成:颜色、结构和感知质量一起提升
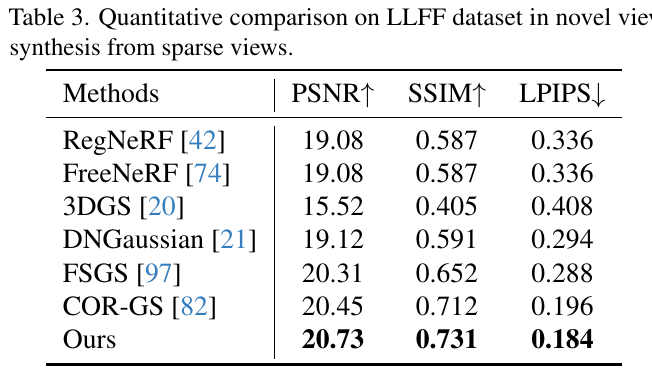
表 3:LLFF 稀疏视图新视角合成结果。
在 LLFF 上,MonoInstance 的 PSNR、SSIM 和 LPIPS 分别为 20.73、0.731 和 0.184,三项都优于表中的 RegNeRF、FreeNeRF、3DGS、DNGaussian、FSGS 和 COR-GS。这里 LPIPS 越低越好,因此 0.184 不只是数值更小,也意味着感知特征上的差异更小。
消融:不确定性、采样和掩码约束逐级贡献
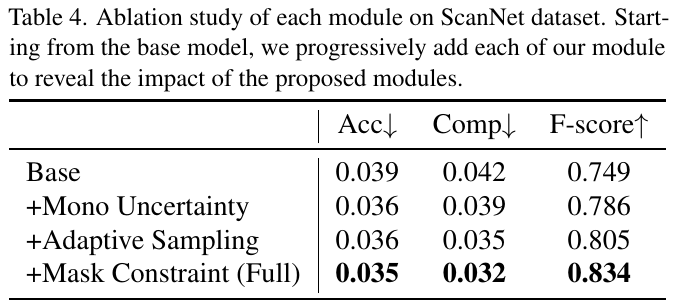
表 4:ScanNet 上逐步加入各个模块的消融。从 Base 到完整模型,Acc 从 0.039 降到 0.035,Comp 从 0.042 降到 0.032,F-score 从 0.749 升到 0.834。只加入 Mono Uncertainty 后 F-score 已升至 0.786,再加入 Adaptive Sampling 和完整 Instance Mask Constraint 后继续升高。
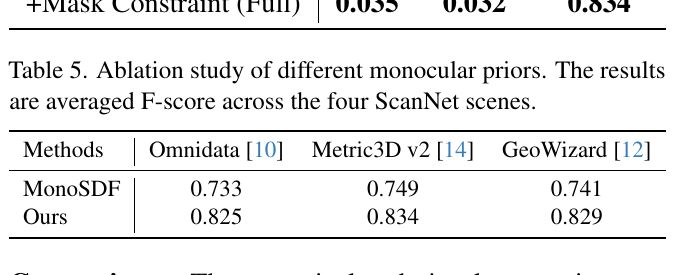
表 5:不同单目先验的比较。MonoInstance 不依赖某一个特定深度模型:Omnidata、Metric3D v2 和 GeoWizard 下的 F-score 分别达到 0.825、0.834 和 0.829,相比对应的 MonoSDF 结果 0.733、0.749 和 0.741 都有明显提升。
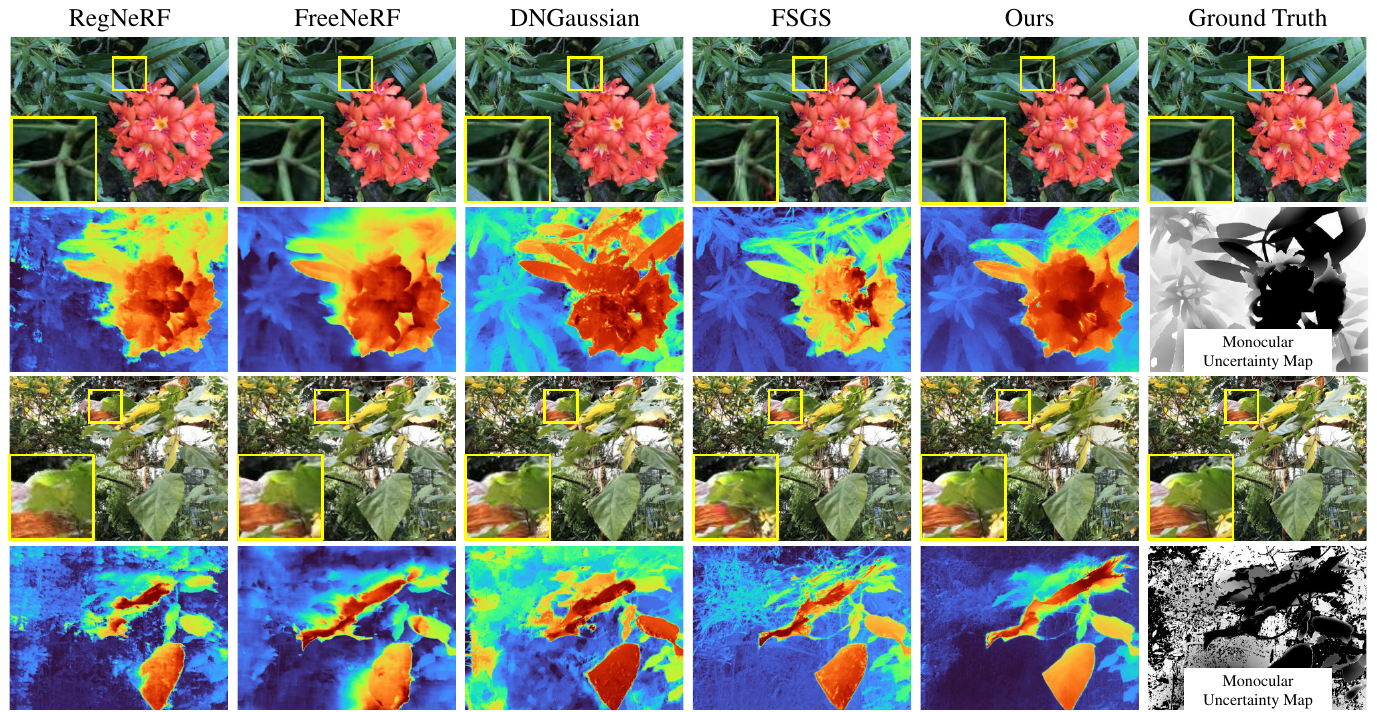
图 6:LLFF 稀疏新视角合成的定性结果。图中白色越多表示单目不确定性越高;MonoInstance 在高不确定性区域仍能恢复更稳定的结构和颜色。
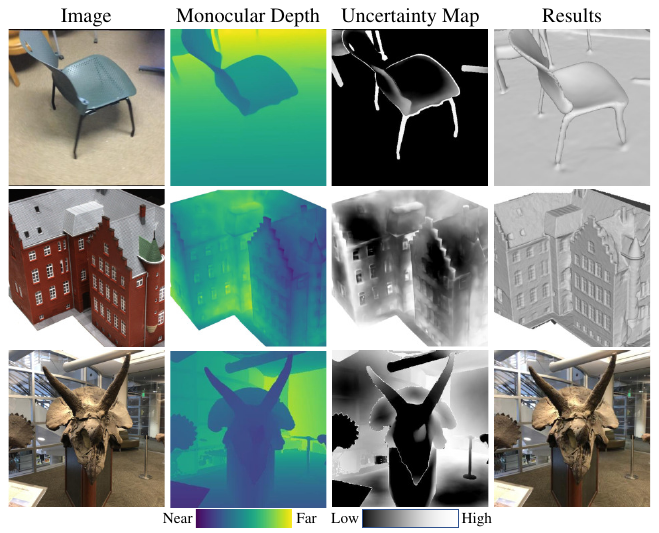
图 7:不同数据上的不确定性图。输入图像、单目深度和估计的不确定性共同显示,点密度能够把多视角中不一致的单目线索定位到具体实例结构。
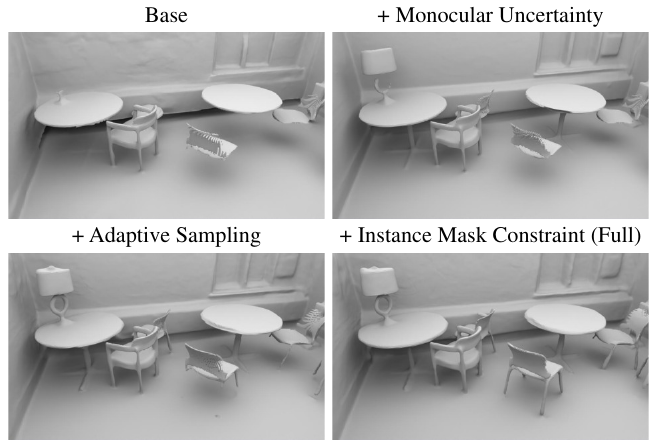
图 8:模块消融的可视化。逐步加入单目不确定性、自适应采样和实例掩码约束后,场景中的椅子、桌子等几何结构逐渐变得完整。
优势与不足
优势
- 不确定性来自多视角几何,而不是渲染分支自评。实例点云密度提供了与 NeRF、SDF 或 3DGS 相对解耦的误差证据,避免“渲染失败导致不确定性预测也失败”的耦合。
- 实例级对齐比整图加权更有针对性。把同一物体的深度放到统一 3D 空间,可以把椅腿、灯架等局部结构的跨视图不一致显式暴露出来。
- 三种策略形成闭环。自适应先验损失减少错误监督,引导采样把预算放到难点,实例掩码约束再利用附近视图的 photometric consistency 补回复杂结构。
- 任务和先验具有可迁移性。方法覆盖密集重建、稀疏重建和稀疏 NVS,并在三种单目先验上都有效。
不足
- 前置条件较强。方法需要多视角图像、相机位姿、实例分割和可用的单目深度;实例图聚类与回投影会增加预处理成本。
- 点密度依赖视角覆盖和尺度对齐。遮挡严重、视角极少或 scale-shift 对齐不稳定时,低密度可能同时反映观测不足和深度错误,二者不容易完全区分。
- 背景置零带有场景假设。把 GroundedSAM 识别的背景不确定性设为零,依赖纹理弱区域的单目先验通常更可靠;在户外、反光背景或背景本身有复杂几何时需要重新验证。
- 算力与训练细节不完整。主文没有给出 GPU、batch size 和训练时长,无法据此严谨比较工程成本;部分实现细节被放在 supplementary materials 和代码仓库中。
- 实验覆盖仍有边界。密集重建主要验证室内 ScanNet/Replica,稀疏重建和 NVS 使用 DTU/LLFF;将实例对齐用于动态物体、户外大场景或无精确位姿输入,仍需要额外实验。
记忆点
- 单目深度的“不确定性”可以从跨视图 3D 点云的局部密度中得到,而不必训练一个与渲染网络强耦合的不确定性分支。
- 先按实例对齐,再估计密度,能避免不同物体尺度差异把不确定性统计混在一起。
- 高不确定性区域不应简单丢弃:用它降低错误深度权重,同时增加射线采样,并通过邻近视图实例掩码挖掘 photometric supervision。
- 一个好的先验增强方法不应只在单一任务有效;MonoInstance 用同一套不确定性思路连接了 SDF/NeRF 重建与 3DGS 稀疏新视角合成。
 微信
 支付宝