Scalix: Uncertainty-Aware Scale-Consistent Monocular SLAM
作者:Sebastian Barbas Laina, Tianyi Zhang, Panagiotis Petropoulakis, Simon Schaefer, Simon Boche, Jaehyung Jung, Cedric Le Gentil, Stefan Leutenegger
单位:当前 arXiv v1 未列出作者单位
会议:2026 Arxiv
研究动机
单目 SLAM 只使用一台相机,硬件简单、信息密度高,但它天生只能恢复 up-to-scale 的几何:相机轨迹和地图整体乘上任意一个尺度,图像重投影误差仍然可以保持不变。多相机、激光雷达或视觉惯性组合能够提供尺度,却带来了外参标定、传感器同步和硬件体积问题。对于小型无人机等平台,视觉惯性系统在匀速运动时也可能失去可观测尺度。
近年来的单目 metric depth 模型可以从单帧 RGB 估计带有米制意义的深度,为单目 SLAM 提供了很有价值的先验。然而,这类预测在连续帧之间往往存在噪声、尺度漂移和时间不一致:如果直接把每一帧深度当作真值,SLAM 后端会被错误深度牵着走;如果每个窗口单独做尺度对齐,又会牺牲流式处理和长期一致性。已有深度增强型 SLAM 还常常依赖稠密 bundle adjustment 或迭代式尺度校正,难以同时满足实时性、长轨迹稳定性和跨场景泛化。
Scalix 的核心问题是:能否把单目深度的“像素级不确定性”和“整帧尺度不确定性”都作为概率测量,直接放进实时因子图,让尺度在多视角数据关联中被联合优化?
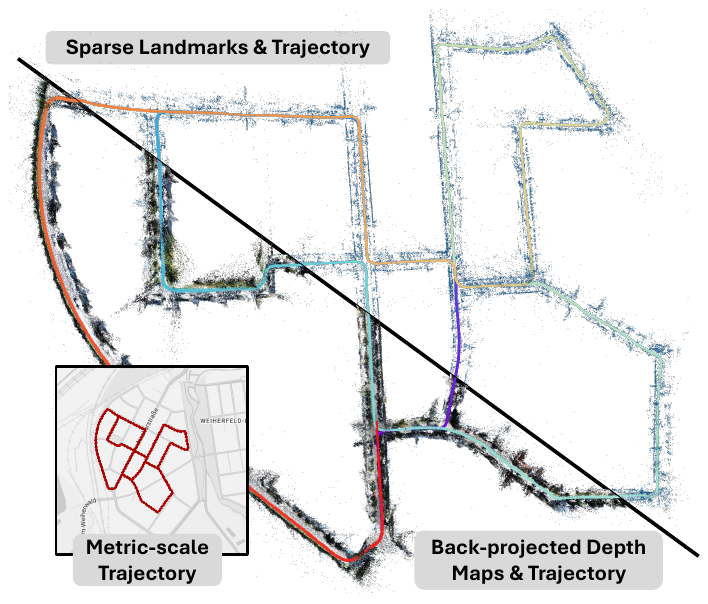
图 1:论文展示的长序列结果。彩色轨迹、稀疏路标和按优化尺度回投影的稠密深度共同说明,Scalix 试图在大尺度场景中恢复稳定的 metric-scale 轨迹。
核心方法
Scalix 建立在 OKVIS2 风格的经典 SLAM 架构上,将学习到的深度先验接入前端初始化和后端因子图。系统包含实时局部窗口估计器,以及在回环后异步优化完整轨迹的全图估计器。论文系统总览如下:
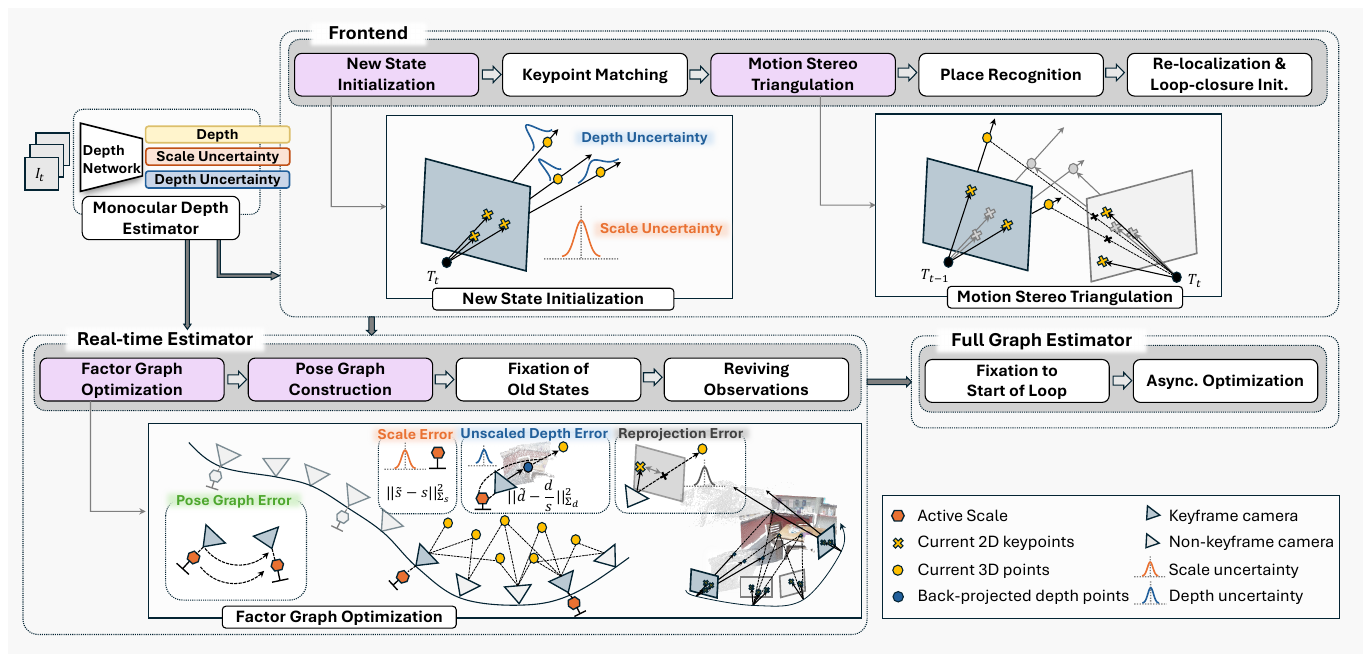
图 2:Scalix 的系统总览。粉色模块是论文加入的关键组件:每个关键帧拥有一个额外的尺度状态,后端同时使用重投影、未缩放深度和尺度先验误差。
1. 把 metric depth 拆成尺度与像素深度
论文不把网络输出的深度直接视为完全可靠的米制量,而是将真实 metric depth 写成一个全局尺度和逐像素深度的乘积:
其中,$d$ 是网络预测的未缩放深度,$s$ 是当前帧的全局深度尺度。对于一个大多数情况下已经接近米制的基础模型,论文令尺度先验满足 $s \sim \mathcal{N}(1,\sigma_s^2)$;逐像素预测则满足 $d \sim \mathcal{N}(\tilde d,\Sigma_d)$,其中 $\Sigma_d=\operatorname{diag}(\sigma_d^2)$。
这个拆分很关键:尺度误差会同时影响一整帧的所有像素,所以 metric depth 的像素之间并非独立。通过不确定性传播,论文得到:
第一项刻画共享的全局尺度不确定性,第二项刻画独立的像素深度不确定性。随后用多元高斯负对数似然训练不确定性头,而不是只对每个像素学习一个互不相关的方差。
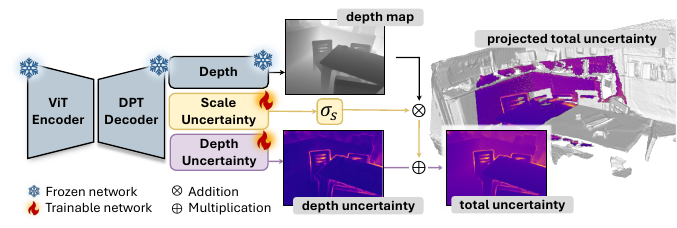
图 3:在 Metric3Dv2 上增加解耦不确定性预测。黄色分支输出每帧一个尺度不确定性,紫色分支输出逐像素深度不确定性,二者再被合成为总 metric-depth 不确定性。
论文使用 Metric3Dv2-small 作为基础网络:DINOv2-reg ViT-S 编码器和 DPT 解码器保持冻结,只训练两个不确定性预测头。尺度头利用全局特征,通过步幅卷积、自适应平均池化和 MLP 输出一个标量;深度不确定性头沿用深度头的 CNN 结构,读取特征、初始深度和置信度图,输出每个像素的方差。
2. 前端:深度初始化与运动立体检查
当关键帧产生新的关键点时,Scalix 使用预测深度和当前尺度初始化路标:
为避免极端预测污染地图,只有深度落在 $[0.01\text{ m},30\text{ m}]$ 内的点才会被直接初始化。除此之外,系统还用相邻关键帧之间的运动立体三角化建立路标;之前因为深度范围被拒绝的观测,如果通过带有传播不确定性的 $\chi^2$ 一致性检验,也可以重新被接纳。这样,网络先验和多视角几何互相校验,而不是单向信任单帧深度。
前端还包含关键点匹配、DBoW2 场所识别、几何验证和回环重定位。论文的因子图结构如下:
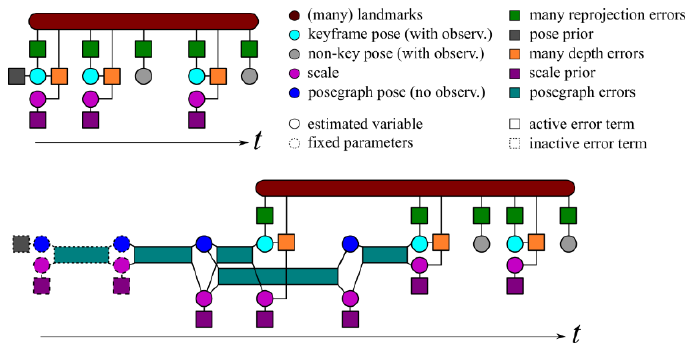
图 4:Scalix 因子图。上方是实时局部窗口,下方是边缘化后的完整实时估计器;旧路标被消去后,相关约束被转写为带相对尺度的位姿图边。
3. 后端:让尺度成为可优化状态
Scalix 将每个图像状态写成包含尺度的变量:
后端使用三个主要残差:
- 重投影误差约束关键点在图像中的位置,主要提供旋转和 up-to-scale 平移约束。
- 未缩放深度误差把路标的几何深度与网络深度联系起来,并除以待优化的尺度 $s_k$,从而让位姿和尺度能够共同调整。
- 尺度误差将优化尺度锚定到网络的每帧尺度先验,论文中该先验均值为 $\tilde s_k=1.0$,方差来自尺度不确定性。
窗口变老后,Scalix 按 OKVIS2 的策略边缘化路标。不同之处在于,相对状态由 6 DoF 位姿扩展为“相对位姿 + 相对尺度”:
通过 Schur complement,原本依赖路标的误差被转成 pose-scale graph edge;当两帧都没有尺度关联时,该项自然退化为普通的 6 DoF 相对位姿误差。最终目标函数用 Cauchy 鲁棒核处理重投影和深度残差,并按协方差逆矩阵加权。尺度因此不再是优化前后单独处理的后验修补,而是和路标、位姿一起接受多视角约束。
数据集
论文把训练和评估数据分开使用:
- 不确定性头训练:使用 ScanNet 和 Waymo 的 metric-depth 数据;Metric3Dv2 主干冻结,只训练尺度头和深度不确定性头,训练时长为一天。
- 室外评估:KITTI,包含灰度/RGB 双目相机、LiDAR 和 IMU;实验只使用 RGB 双目中的左目图像,报告 00–10 序列。
- 室内评估:7-Scenes,原始数据由 RGB-D Kinect 采集,但实验只使用 RGB。
评价指标是绝对轨迹误差 ATE 的 RMSE。论文在 Sim(3) 对齐后报告 up-to-scale 能力;对于能产生 metric-scale 估计的方法,还额外进行 SE(3) 对齐。KITTI 中若某条轨迹 ATE 超过序列长度的 3%,就被视为失败,“Avg. success”只在成功序列上平均。
算力
论文给出的实现设置如下:
- 不确定性头训练:单张 NVIDIA L40S,训练一天。
- SLAM 运行设备:Intel i7-13700 CPU + NVIDIA RTX 3080 GPU。
- 实时滑动窗口大小:10。
- 前端关键点匹配约 20 ms,单目网络推理约 79 ms(只在部分帧触发),路标初始化约 5 ms。
- 后端优化约 59 ms。
论文强调系统是实时的,但没有给出一个统一的端到端 FPS;上述分模块时间比单独报 FPS 更能反映其调度方式。
实验结果
KITTI:尺度优化同时改善精度和泛化
主表如下,数值单位为米。“w/o BA”表示主结果没有启用完整 bundle adjustment。
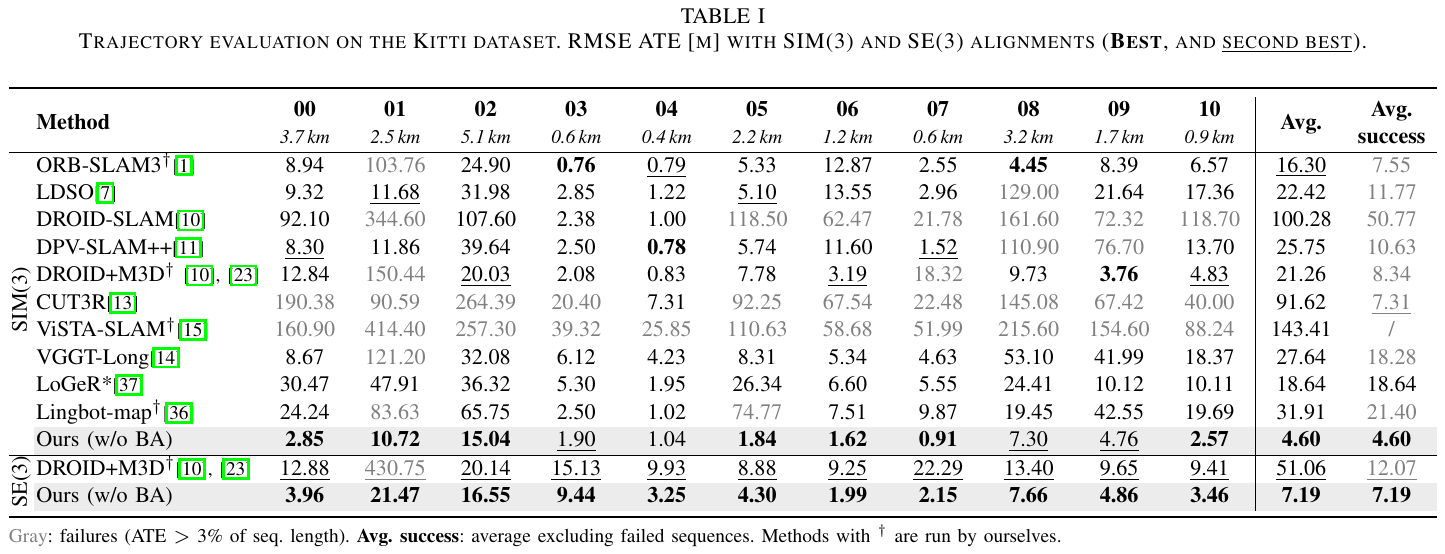
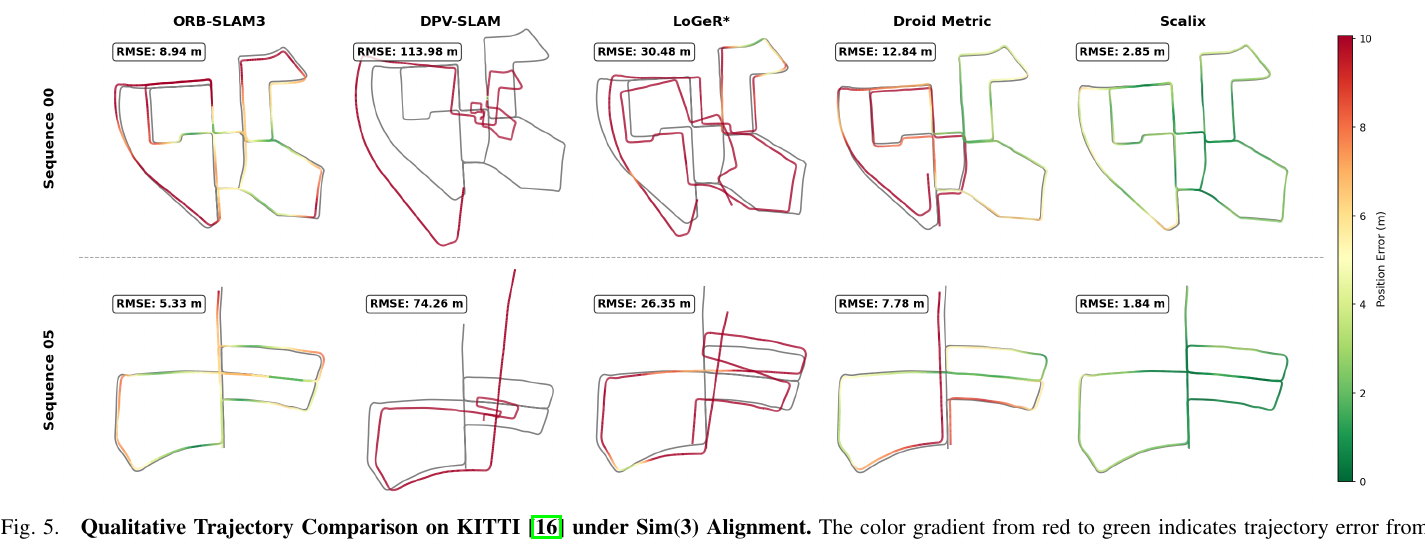
图 5:KITTI 在 Sim(3) 对齐下的定性轨迹比较,颜色由红到绿表示位置误差由高到低。
Scalix 在 Sim(3) 对齐下的平均 RMSE ATE 为 4.60 m,“Avg. success”也为 4.60 m;在 SE(3) 对齐下为 7.19 m。论文报告它在 KITTI 上优于其他单目方法,并称相对第二好的 CUT3R 提升 37%。与同样利用 Metric3D 的 DROID+M3D 相比,Scalix 在 SE(3) 评估下也更好。启用完整 bundle adjustment 后,Sim(3) 和 SE(3) ATE 进一步达到 3.87 m 和 7.22 m。
从图 5 可以看到,某些基线在 KITTI 00 和 05 上出现明显漂移或断裂,而 Scalix 的轨迹整体贴近灰色真值。这里真正有解释力的不只是平均数:11 条序列的误差分布说明了尺度状态和多视角关联对长轨迹稳定性的作用。
7-Scenes:室内不是最强项,但仍保持 metric-scale
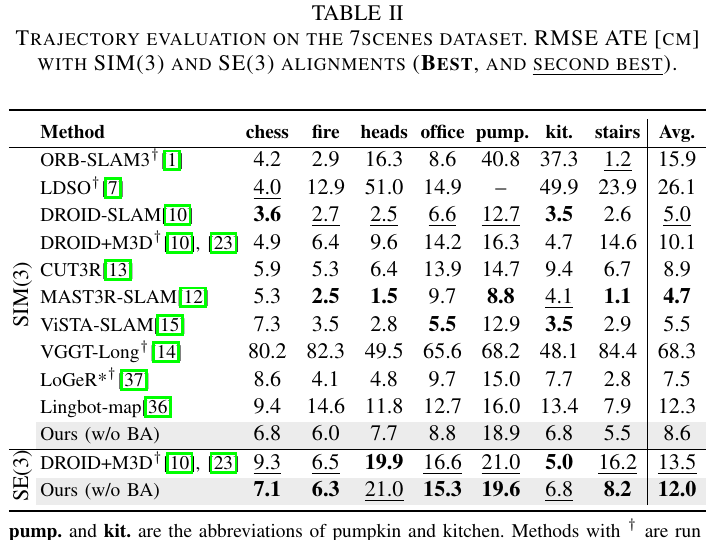
图 6:7-Scenes 的 RMSE ATE,单位为厘米。
在 7-Scenes 上,Scalix 的 “w/o BA” 结果为 Sim(3) 平均 8.6 cm、SE(3) 平均 12.0 cm;加入完整 BA 后,论文报告可达到 7.8 cm 和 11.5 cm。DROID-SLAM、ViSTA-SLAM 和 MAST3R-SLAM 在部分室内序列上略好,但它们在 KITTI 大尺度室外场景上并不具有同样的泛化表现。论文将 Scalix 的室内差距主要归因于 Metric3Dv2 在室内场景中的深度准确性。
消融:优化尺度是主要收益来源
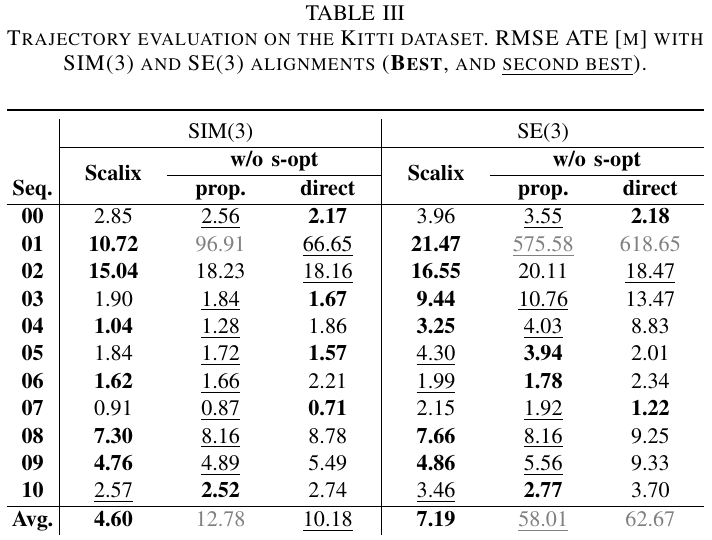
图 7:KITTI 上对尺度优化和不确定性形式的消融。“prop.”是由解耦不确定性传播得到的总不确定性,“direct”是直接预测的总不确定性。
在不启用尺度优化时,Sim(3) 的平均值从 Scalix 的 4.60 m 变为 “w/o s-opt” 的 12.78 m(prop.),SE(3) 则从 7.19 m 变为 58.01 m。即使换成直接预测的逐像素总不确定性,平均值也为 10.18 m 和 62.67 m。这个实验把两个因素拆开了:不确定性传播本身不会损害性能,而将尺度作为后端状态联合优化,才是长期 metric-scale 一致性的关键。
优势与不足
优势
- 把尺度从“后处理”变为状态变量。尺度先验、深度残差、重投影误差和多视角关联在同一个因子图中联合优化,避免每个窗口独立对齐。
- 不确定性建模符合误差结构。全局尺度会在像素之间产生相关性,$\Sigma_s d d^{\mathsf T}$ 显式保留了这种相关,而不是把所有像素简单当成独立观测。
- 兼顾实时性和长轨迹。局部窗口负责实时估计,边缘化后的 pose-scale 图负责低成本的全局维护;网络推理只在部分帧触发。
- 跨室内外验证。KITTI 和 7-Scenes 的组合说明方法不只针对某一种相机或场景。
不足
- 室内深度先验仍是瓶颈。论文自己指出,Metric3Dv2 在室内的准确性限制了 Scalix 与专门室内 SLAM 的差距。
- 每帧只有一个全局尺度。论文的尺度解耦假设把一帧的主要误差压缩成单个 $s_k$;对同一帧存在多种深度尺度、局部非线性畸变或分层场景时,表达能力可能不足,作者也把多尺度假设列为后续方向。
- 主表依赖 “w/o BA” 设置。完整 BA 能进一步降低 ATE,但它的计算代价和实际实时性需要与主结果区分看待。
- 当前版本的代码状态有限。arXiv v1 写明代码将在接收后发布,因此本文无法仅凭当前论文页面复现实验实现细节。
记忆点
- 单目 metric depth 的主要问题不一定是每个像素都错,而可能是整帧尺度在时间上漂移;先把误差结构拆对,后续优化才有意义。
- 共享尺度会产生像素间协方差,误差传播中的低秩项 $\Sigma_s d d^{\mathsf T}$ 是一个可复用的建模技巧。
- 让尺度进入状态向量,并在路标边缘化后保留 pose-scale 相对边,是把 metric prior 变成 SLAM 约束的关键接口。
- 前端不盲信网络深度:深度初始化、运动立体三角化和 $\chi^2$ 检验构成了一个轻量的先验—几何互检机制。
 微信
 支付宝