$R^3$: 3D Reconstruction via Relative Regression
作者:Congrong Xu, Huachen Gao, Xingyu Chen, Yuliang Xiu, Jun Gao, Anpei Chen
单位:University of Michigan、Westlake University、NVIDIA
会议:2026 Arxiv(v2)
链接:arXiv:2605.26519 · Project Page · Code
研究动机
从一段单目视频恢复三维结构,通常要同时得到每帧深度、相机内参和相机位姿。近来的 feed-forward 三维几何模型把这些量直接回归出来,推理速度很快,但一个关键选择会限制它们处理长序列的能力:网络往往要把所有相机放到一个全局坐标系中,再直接预测每一帧的绝对位姿。
绝对位姿回归的问题并不只是“序列变长后显存变大”。第一,相机在全局坐标中的平移会随着轨迹长度增长,训练时看到的局部运动与推理时的长距离坐标可能逐渐不匹配。第二,第一帧锚定的坐标系把整个序列的误差都压到一个全局参考上,远处帧的误差容易表现为漂移。第三,流式输入不能回看全部历史,若仍然依赖完整序列的全局关系,就必须在准确性、上下文长度和内存之间反复取舍。
$R^3$(3D Reconstruction via Relative Regression)的出发点是把学习目标换成局部、可组合的几何关系:对于帧 $i$ 和帧 $j$,网络预测相机 $j$ 相对于相机 $i$ 的旋转与平移,而不是直接预测一个固定世界坐标中的绝对位姿。局部相对位姿主要由两帧之间的基线和可见内容决定,与整条视频已经走了多远关系较小,因此更适合作为长序列模型的基本监督单元。
然而,仅仅把绝对位姿换成相对位姿还不够。一个帧对可能存在运动模糊、遮挡、重复纹理、基线过小或场景切换,所有 pairwise 约束的可靠性并不一样。$R^3$ 因而同时预测旋转置信度和平移置信度,让置信度参与训练损失、全局轨迹融合、关键帧库管理和异常帧拒绝。这样,局部关系不再是彼此孤立的预测,而成为可以按可信程度组装的带权姿态图。
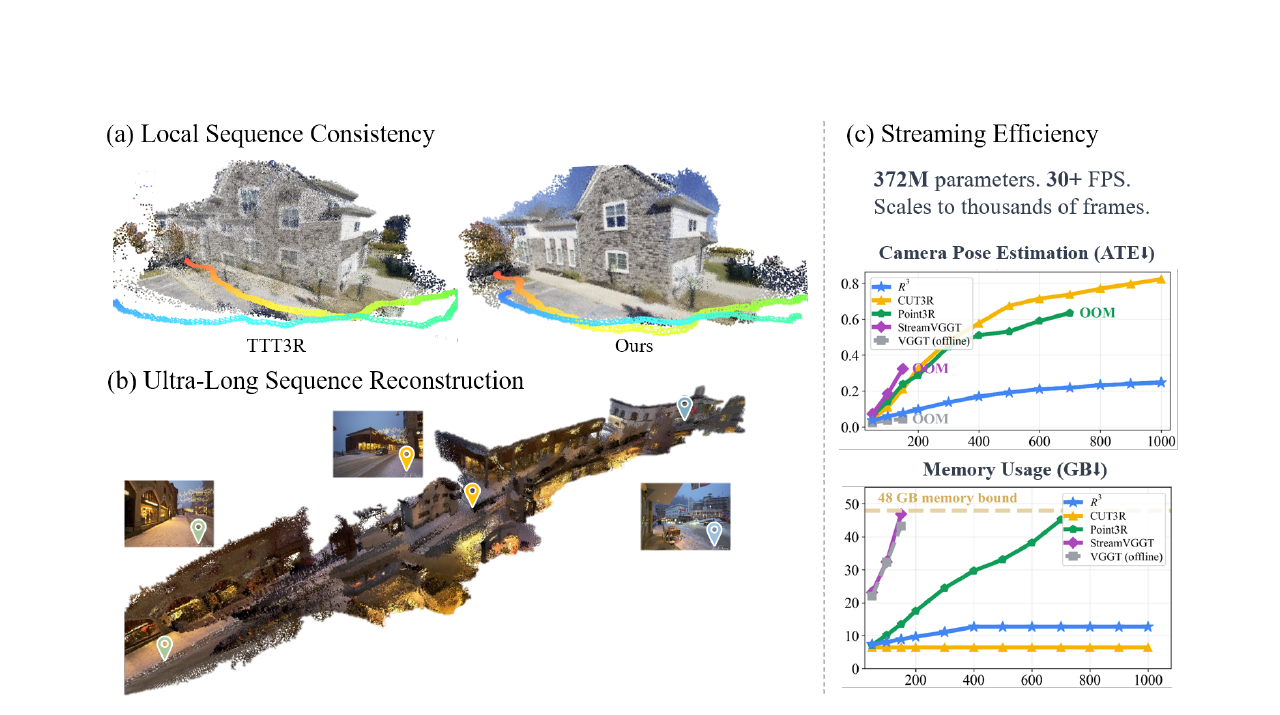
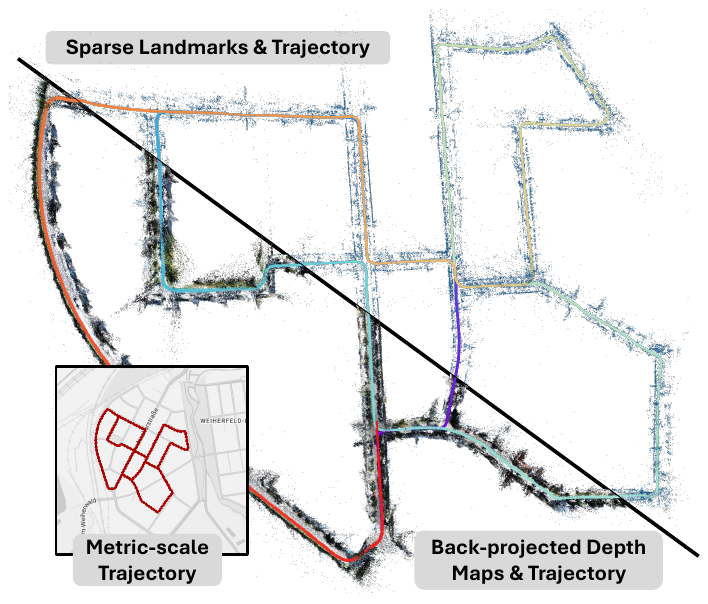
图 1:论文用局部序列一致性、超长序列重建和流式效率概括方法目标。图中展示了相对回归带来的长序列稳定性与有界内存特征;右侧视觉标注写作 30+ FPS,而论文图注正文写作 20+ FPS,本文不把两者混合成一个未经说明口径的硬指标。
核心方法
1. 从全局位姿改成带置信度的相对位姿
论文把一段输入序列记为 ${I_1,\ldots,I_N}$。DA3-Large backbone 为每一帧产生一个 camera token $\mathbf z_i$,并由轻量的相对姿态 MLP 读取一对 token:
其中,$\hat{\mathbf q}{i\to j}$ 是从相机 $i$ 到相机 $j$ 的相对旋转,$\hat{\mathbf t}{i\to j}$ 是在相机 $i$ 坐标系中表达的相机 $j$ 位置,$c^R{i\to j}$ 和 $c^T{i\to j}$ 分别是旋转、平移置信度。两种置信度解耦很重要:某一对帧的朝向可能容易判断,但平移基线很短;也可能平移明显而旋转受动态遮挡影响。一个统一分数会把这两种不确定性混在一起。
相对关系把 $N$ 帧变成一个有向姿态图。相比只从第一帧连向其他帧的锚定图,$R^3$ 在训练时可监督每个有向帧对,从而获得更多局部几何约束。下面的图和表对应论文对三种 feed-forward 姿态范式的比较。
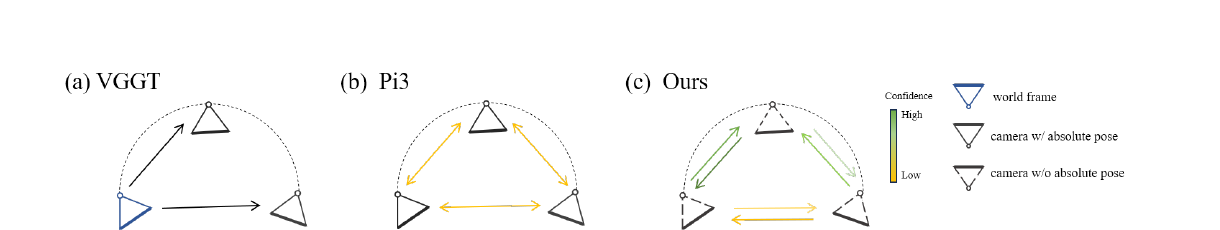
图 2:VGGT 只从第一相机向外监督,Pi3 在模型选择的世界坐标中回归绝对位姿,$R^3$ 则对每个有向帧对回归相对姿态,并为边预测置信度。
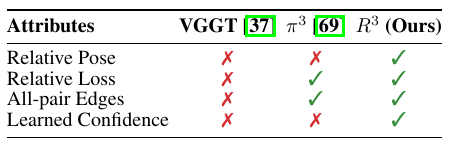
表 1:相对位姿、相对损失、全 pair 边和学习到的置信度在三种范式中的配置对比。
2. 先生成局部边,再聚合全局轨迹
网络的输出是局部边,但深度融合和点云重建最终需要所有相机处于同一坐标系。论文先把相对边转成候选全局位姿。若帧 $i$ 的全局位姿已经估计,那么它对新帧 $j$ 提供一个候选:
随后旋转和位移分别按各自的置信度做 softmax 加权融合:
$\mathcal N_K(j)$ 可以是置信度最高的 $K$ 个参考帧,也可以包含全部可用参考帧。四元数平均前先做符号对齐,避免 $\mathbf q$ 与 $-\mathbf q$ 被错误抵消。附录聚合实验显示,从 Top-1、Top-5 到 Top-10 逐渐扩大参考集,指标持续改善;使用全部参考并加入轻量 pose-graph optimization 后,平均值进一步下降。
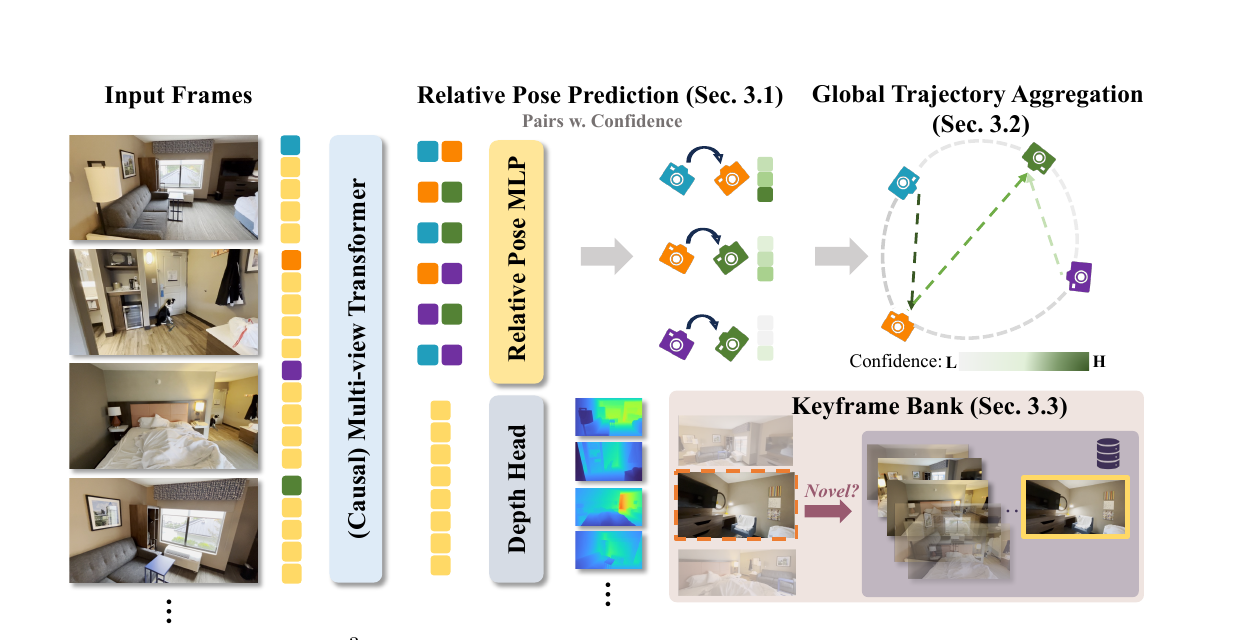
图 3:$R^3$ 的整体流程。多视角 transformer 产生 camera tokens;相对姿态 MLP 为帧对输出旋转、平移和置信度;depth head 产生深度;最后由全局轨迹聚合器和关键帧库支持离线或流式重建。
3. 有界内存的因果流式推理
流式模式下,输入帧一次到达,系统不能保留完整历史。论文维护一个主动上下文:
其中第一帧固定轨迹原点,$B_t$ 是动态关键帧库。新帧 $j$ 只有在与当前关键帧足够不同的时候才进入库:
这里使用 backbone 在跨帧交互前的 token 相似度来判断新颖性,避免把连续、近乎重复的画面都存下来。关键帧库达到容量 $M{\max}$ 后,系统计算 token 新颖性与 pair confidence 的联合效用 $u_j=d_jc_j$,移除最不值得保留的条目;第一帧受到保护。论文附录给出的代表性设置包括 $M{\max}=100$,若连续 $\Delta_{\max}=20$ 帧没有加入关键帧则强制接纳一帧。
这让计算规模由“总历史长度”变成“主动上下文大小”。新帧只和 $C_t$ 中的参考帧计算相对关系,再由置信度加权得到位姿。对突然模糊、遮挡或场景切换的帧,置信度还可以触发缓存失效、跳过关键帧接纳以及抑制该帧位姿。
4. 同一模型兼容 full-context
如果完整视频片段在推理时已经可用,$R^3$ 只需去掉 causal attention mask,就可以让 backbone 同时看到所有帧,并查询每个有向帧对。论文先用一次因果流式过程初始化轨迹,再执行一次轻量的置信度加权 pose-graph refinement。这个 refinement 只处理相对位姿残差和标量置信度,不包含 bundle adjustment、点重投影或深度优化,所以它不是第二套离线模型,而是同一 checkpoint 的测试时上下文开关。
5. 置信度加权训练目标
旋转、平移的监督残差分别写成:
$\alpha=0.2$。当 pair 的预测残差较大时,第一项会促使网络降低对应置信度;$-\log c$ 正则项又避免置信度塌缩到零。训练最终学到的是“低残差边高置信、高残差边低置信”的可复用信号,而不是只在测试时临时估计一个分数。总损失为:
深度分支在每帧内部做 median normalization,以消除场景尺度歧义;合成数据使用真实深度,真实世界序列使用冻结的预训练 DA3 产生监督目标,并学习逐像素深度置信度。也就是说,论文同时在 pair 级和 pixel 级使用了不确定性加权,但真正支撑长序列控制的是旋转/平移 pair confidence。
数据集
论文从四个维度评估:
- 相机位姿:Sintel 使用 50 帧片段,TUM-dynamics 与 ScanNet 使用 90 帧片段,报告 ATE、RPE-T 和 RPE-R。
- 稀疏视图点图重建:在 7-Scenes 与 NRGBD 上按步长 200、100 采样关键帧,报告 Accuracy、Completeness 和 Normal Consistency 的均值与中位数。
- 长序列:7-Scenes 测试长度 200、500、1000;ScanNet/TUM-dynamics 观察输入视图增加时的 ATE;DL3DV-Benchmark 取 25 个、长度 304–439 帧且具有更宽基线和户外场景的片段。
- 干扰鲁棒性:遵循 Robust-VGGT 协议,在 ETH3D 与 RobustNeRF 中插入 Small/Medium/Large distractor,三种设置各使用 10 个随机种子。
训练方面,附录 Table 10 列出 15 个公开数据集:AriaSyntheticENV、ARKitScenes、CO3Dv2、DL3DV、HyperSim、MapFree、MVS-Synth、OmniWorld-Game、ScanNet、ScanNet++、Spring、TartanAir、Dynamic Replica、Virtual KITTI 2 和 WildRGBD。数据源同时覆盖合成、COLMAP、LiDAR/RGB-D 与真实世界视频,目的是让相对关系和深度 head 不只适应单一传感器或室内分布。
算力
论文主文给出的模型规模是 372M 参数,训练使用 6 张 48GB GPU;作者强调这大约是近期 1B 级 feed-forward 重建模型的三分之一。训练时大部分 DA3-Large backbone 保持冻结,只更新 global attention 层和相对姿态 head,约 110M 参数参与训练。
训练片段长度为 4–32 views,前期大多数 batch 最多 16 帧,后半程扩展到 32 帧;使用 gradient checkpointing、bf16 和 FlexAttention。在没有 DA3 teacher 时,每张 GPU 的吞吐上限约为 200 views;需要 teacher 时约为 96 views。优化分为两阶段:第一阶段 15k iterations,第二阶段专门训练相对 head 25k iterations,使用 AdamW,学习率从 $10^{-4}$ 经过 cosine schedule 降到 $10^{-5}$,并在第二阶段使用梯度累积。
论文 Figure 1 的图注将方法概括为 20+ FPS、372M 参数和可扩展到数千帧;同一视觉面板中的文字标注为 30+ FPS。由于论文没有在这两个数字旁给出统一的硬件与测量口径,阅读时应把它们理解成效率示意,而不是可直接复现的单一 benchmark。项目页和代码仓库还会随版本更新提供更具体的推理信息,部署或复现实验应以对应 release 为准。
实验结果
1. 短序列相机位姿
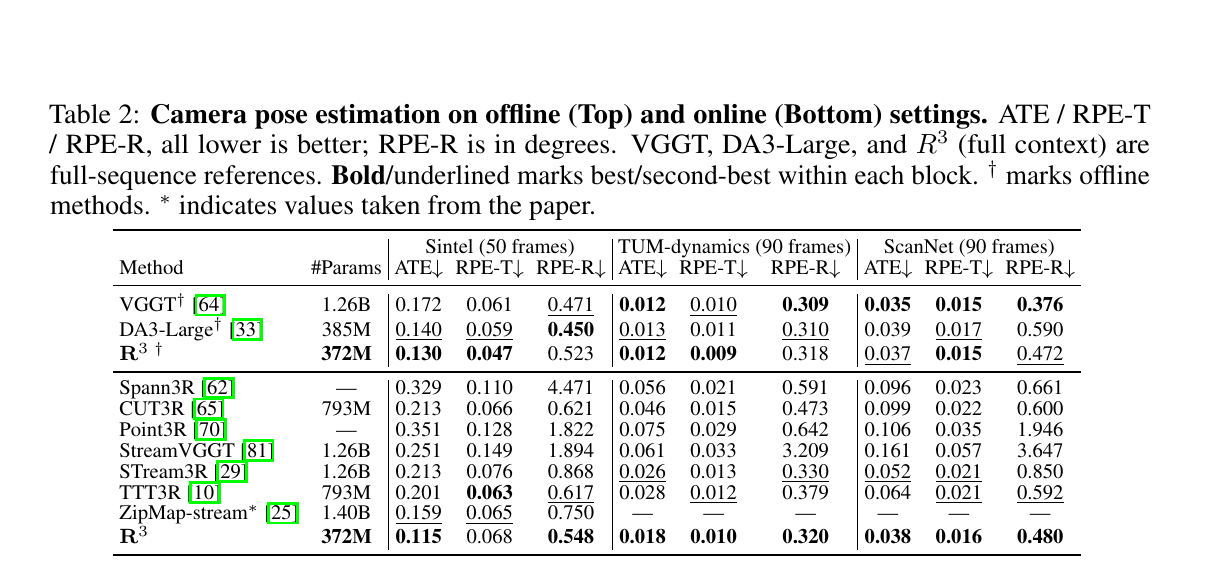
表 2:离线结果在上、流式结果在下;ATE、RPE-T、RPE-R 均为越低越好,RPE-R 的单位是度。$R^3$ 的 full-context 结果使用同一 checkpoint 关闭 causal mask。
流式 $R^3$ 在三套数据上的结果为:
- Sintel:ATE 0.115、RPE-T 0.068、RPE-R 0.548;
- TUM-dynamics:ATE 0.018、RPE-T 0.010、RPE-R 0.320;
- ScanNet:ATE 0.038、RPE-T 0.016、RPE-R 0.480。
它在整体位姿表现上优于多数流式基线,同时模型只有 372M 参数;例如 CUT3R 为 793M,StreamVGGT 为 1.26B。也要保留表格中的细节:Sintel 上 TTT3R 的 RPE-T 为 0.063,略低于 $R^3$ 的 0.068,因此“整体最强”不能被误读为每个单项都第一。full-context 模式下,$R^3$ 在 Sintel/TUM-dynamics/ScanNet 的 ATE 分别为 0.130/0.012/0.037,与 DA3-Large 和 VGGT 的全序列参考结果保持竞争力;Sintel 的相对较弱表现主要与 sintel-temple-3 这一异常序列有关。
2. 点图重建
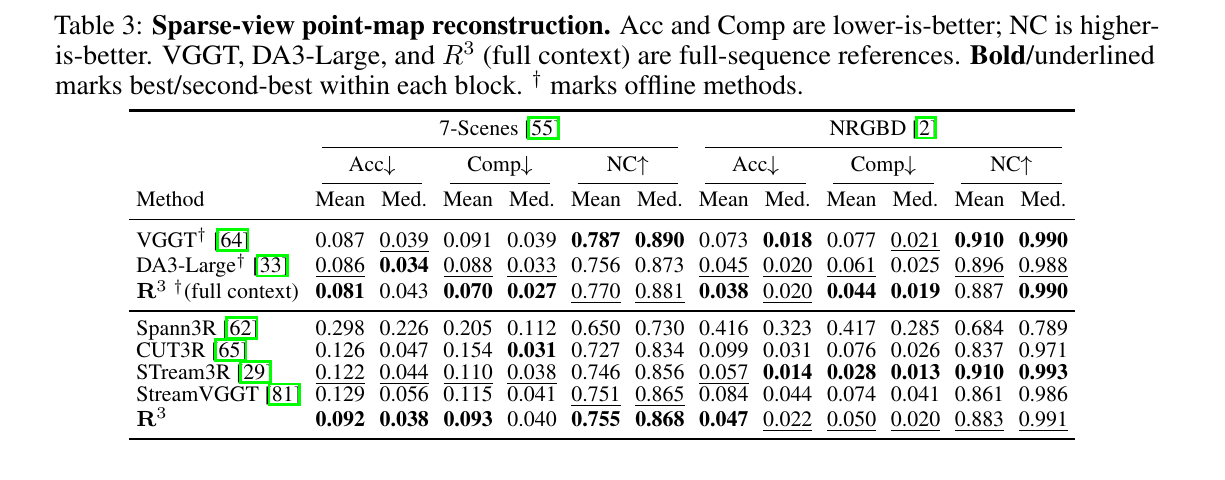
表 3:7-Scenes 与 NRGBD 上的 sparse-view point-map reconstruction。Accuracy、Completeness 越低越好,Normal Consistency 越高越好。
在 7-Scenes 上,流式 $R^3$ 的 Accuracy mean/median 为 0.092/0.038,Completeness 为 0.093/0.040,NC 为 0.755/0.868;full-context 切换后,主要 mean 指标改善为 Accuracy 0.081、Completeness 0.070。NRGBD 上流式结果为 0.047/0.022、0.050/0.020、0.883/0.991,仍与最强流式方法接近。这个结果说明相对边的价值不止体现在轨迹表格中:当稀疏关键帧被放进同一坐标系时,更稳定的位姿也会直接改善点图的对齐。
3. 长序列稳定性
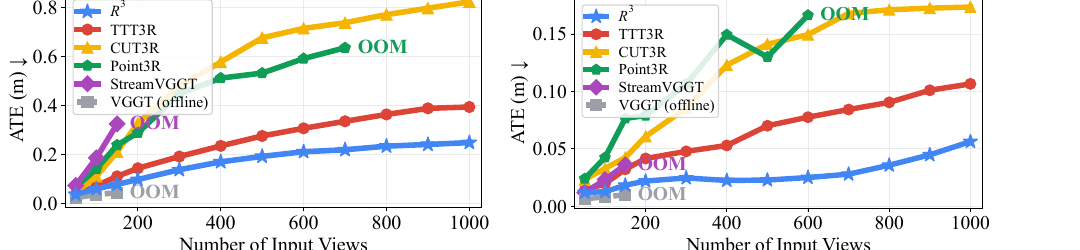
图 4:随着输入帧数增加,ScanNet 与 TUM-dynamics 上的 ATE 曲线。若模型发生 OOM,曲线用 OOM 标记。
图 4 的趋势不是“误差完全不增长”,而是 $R^3$ 的增长更缓且不容易因为历史变长而超出显存。相比之下,若干基线在几百帧后漂移明显,或直接触及 48 GiB 内存上限。论文将这种稳定性归因于对关键帧库的有界访问,以及置信度对边权的筛选。
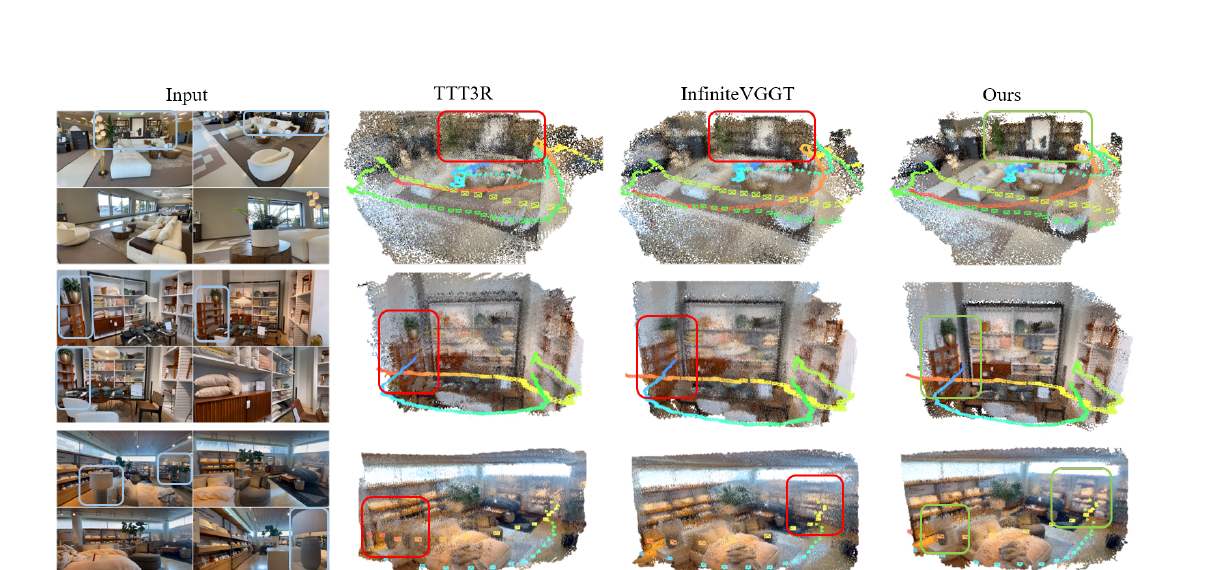
图 5:户外长流式片段的定性比较。三行场景中,$R^3$ 的轨迹和 point-map 对齐在数百帧尺度上更完整。
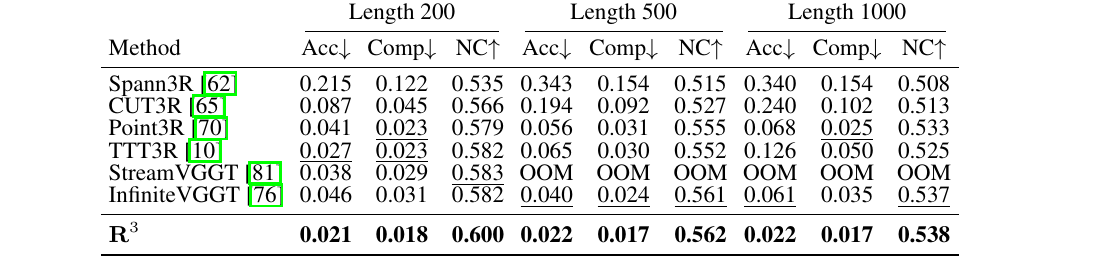
表 4:7-Scenes 长序列重建。$R^3$ 在长度 200/500/1000 时的 Acc、Comp、NC 分别为 0.021/0.018/0.600、0.022/0.017/0.562、0.022/0.017/0.538,三种长度的数值都保持得很平。
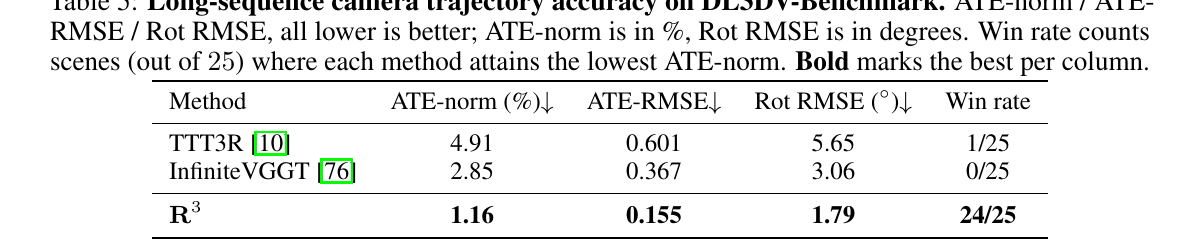
表 5:DL3DV-Benchmark 的相机轨迹。$R^3$ 的 ATE-norm、ATE-RMSE、Rot RMSE 和 win rate 为 1.16%、0.155、1.79°、24/25。这个测试比主要的室内数据更接近宽基线和户外情况,表明局部相对关系在分布变化下仍能组装出稳定轨迹。
4. 干扰帧与置信度门控
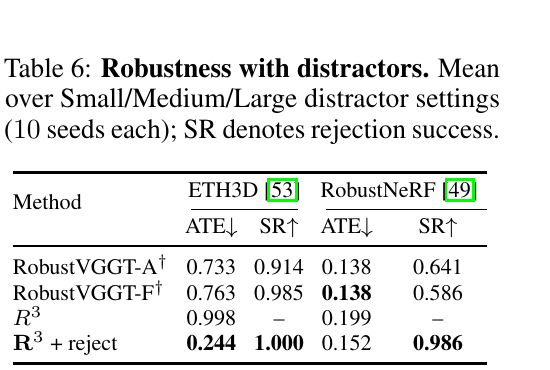
表 6:插入干扰帧后的鲁棒性。裸 $R^3$ 在 ETH3D/RobustNeRF 上的 ATE 为 0.998/0.199;启用 reject 后降为 0.244/0.152,拒绝成功率分别为 1.000/0.986。对比方法 RobustVGGT 需要额外的多遍离线检测,而 $R^3$ 在单次在线过程中复用 pair confidence 完成缓存失效、跳过关键帧和抑制异常位姿。
这部分实验清楚地展示了置信度的“跨模块复用”:它不是一个只用于画热力图的附加输出,而是将局部几何判断转化为系统控制信号。不过,裸模型在不启用 reject 时并不鲁棒,说明门控规则仍是完整系统的一部分,不能只复现相对 pose head 就宣称获得同样的抗干扰能力。
5. 相对目标的消融
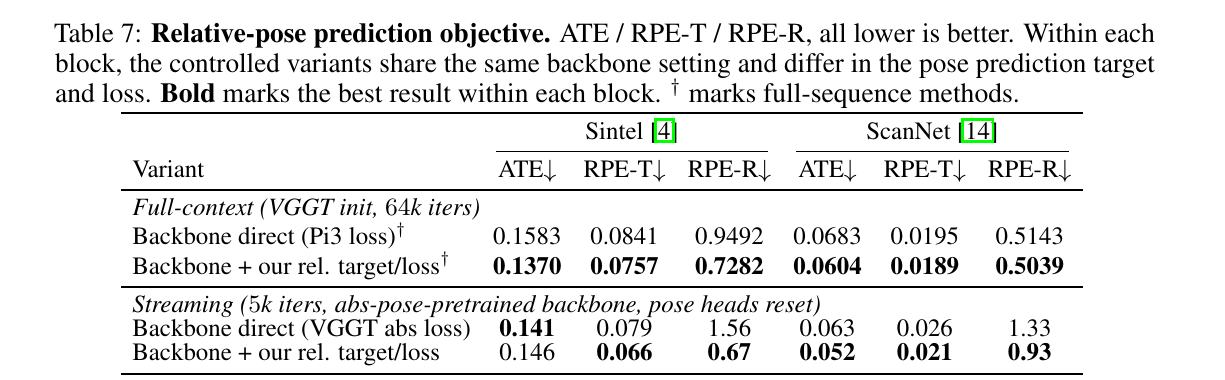
表 7:在相同 backbone、数据和优化预算下,只改变位姿预测目标与损失。full-context 中,Sintel 的 ATE/RPE-T/RPE-R 从 direct baseline 的 0.1583/0.0841/0.9492 降到 0.1370/0.0757/0.7282,ScanNet 从 0.0683/0.0195/0.5143 降到 0.0604/0.0189/0.5039。streaming 中,相对目标把 ScanNet 的三项从 0.063/0.026/1.33 改善为 0.052/0.021/0.93;Sintel 的 ATE 则从 0.141 变为 0.146,略有回退。
这个控制实验很关键:长序列上的收益不只是因为后面加了关键帧库或 pose-graph refinement,而是相对姿态本身提供了更适合学习的几何先验。另一方面,Sintel streaming ATE 的小幅回退也提醒我们,相对目标不是对所有数据和指标都无条件占优。
优势与不足
优势
- 学习目标更贴近局部几何。 预测两帧之间的相对关系,降低了网络直接记忆长距离全局坐标的负担;全局轨迹变成下游可解释的组装过程。
- 置信度形成统一控制回路。 旋转/平移置信度同时用于 loss weighting、候选位姿融合、关键帧保留和 outlier rejection,训练信号与系统行为是一致的。
- 流式与离线共用 checkpoint。 因果 mask 控制是否看全上下文,避免为短片段和长视频维护两套完全不同的模型。
- 长序列证据比较完整。 论文同时给出短序列位姿、稀疏点图、1000 帧重建、DL3DV 宽基线和干扰帧实验,覆盖了精度、内存和鲁棒性三个层面。
不足
- 模型依然不算轻。 372M 参数、约 110M 可训练参数和 6 张 48GB GPU 的训练配置,对边缘端无人机或机器人平台仍然有明显门槛。
- 关键阈值依赖人工设置。 关键帧新颖性 $\tau$、库容量 $M{\max}$、强制接纳间隔 $\Delta{\max}$ 以及异常拒绝阈值都需要根据数据分布调整,论文没有把它们完全学习化。
- 流式模式仍可能漂移。 因果系统不能重新访问过去 token,远距离视角、遮挡和很长的连续运动会留下残余几何不一致;没有周期性 reset 时尤其如此。
- 没有消除全局优化的取舍。 full-context 仍然需要一次 pose-graph refinement,流式系统则用有限主动上下文换取内存上界;相对回归降低了漂移风险,却没有从理论上消除累计误差。
- 泛化与扩展空间尚未充分展开。 论文没有系统探索更大 backbone、更大规模数据、联合 BA 或深度-位姿的全局重优化;主要定量评估仍集中在室内数据,DL3DV 只是一组更宽基线的补充测试。
记忆点
- 先回归局部边,再组装全局轨迹。 $R^3$ 的核心不是又一个绝对位姿头,而是改变了 feed-forward 三维重建的基本监督单位。
- 置信度不是附属分数,而是控制信号。 旋转和平移的可信程度贯穿训练、融合、内存管理和异常拒绝。
- 有界关键帧库把无限历史变成主动上下文。 通过 token 新颖性和置信度共同决定“留谁、删谁、信谁”。
- 一个 causal checkpoint,通过 attention mask 切换兼容 streaming 与 full-context。
- 相对回归缓解坐标负担,但不等于没有漂移。 真正的长序列系统仍需要合理的参考帧选择、置信度门控,以及在必要时进行全局修正。
 微信
 支付宝