WildRayZer: Self-supervised Large View Synthesis in Dynamic Environments
作者:Xuweiyi Chen, Wentao Zhou, Zezhou Cheng
单位:University of Virginia
会议:2026 CVPR
链接:https://wild-rayzer.cs.virginia.edu/
研究动机
现有自监督新视角合成方法均基于三维场景静态假设
核心方法
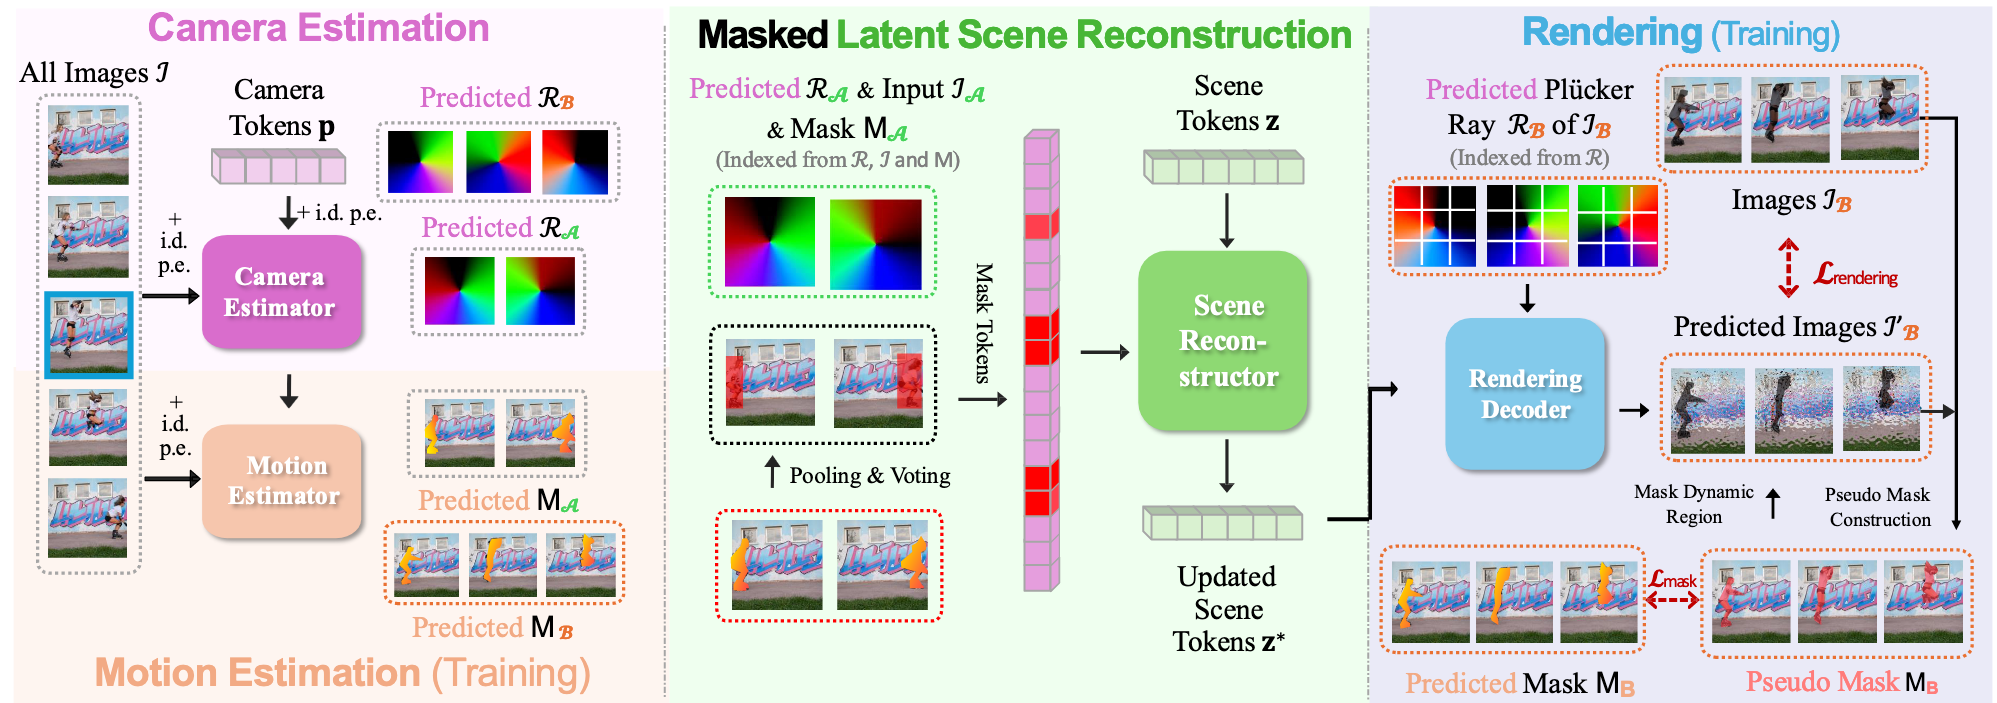
1.构造动态数据集
通过挖掘网络手持影像构建动态数据集D-RE10K
2.融合DINOV3特征的伪运动标签构建

3.mask动态物体进行render
数据集
- Dynamic RealEstate-10K
- D-RE10K-iPhone
- RealEstate10K
算力
4张H100
实验结果

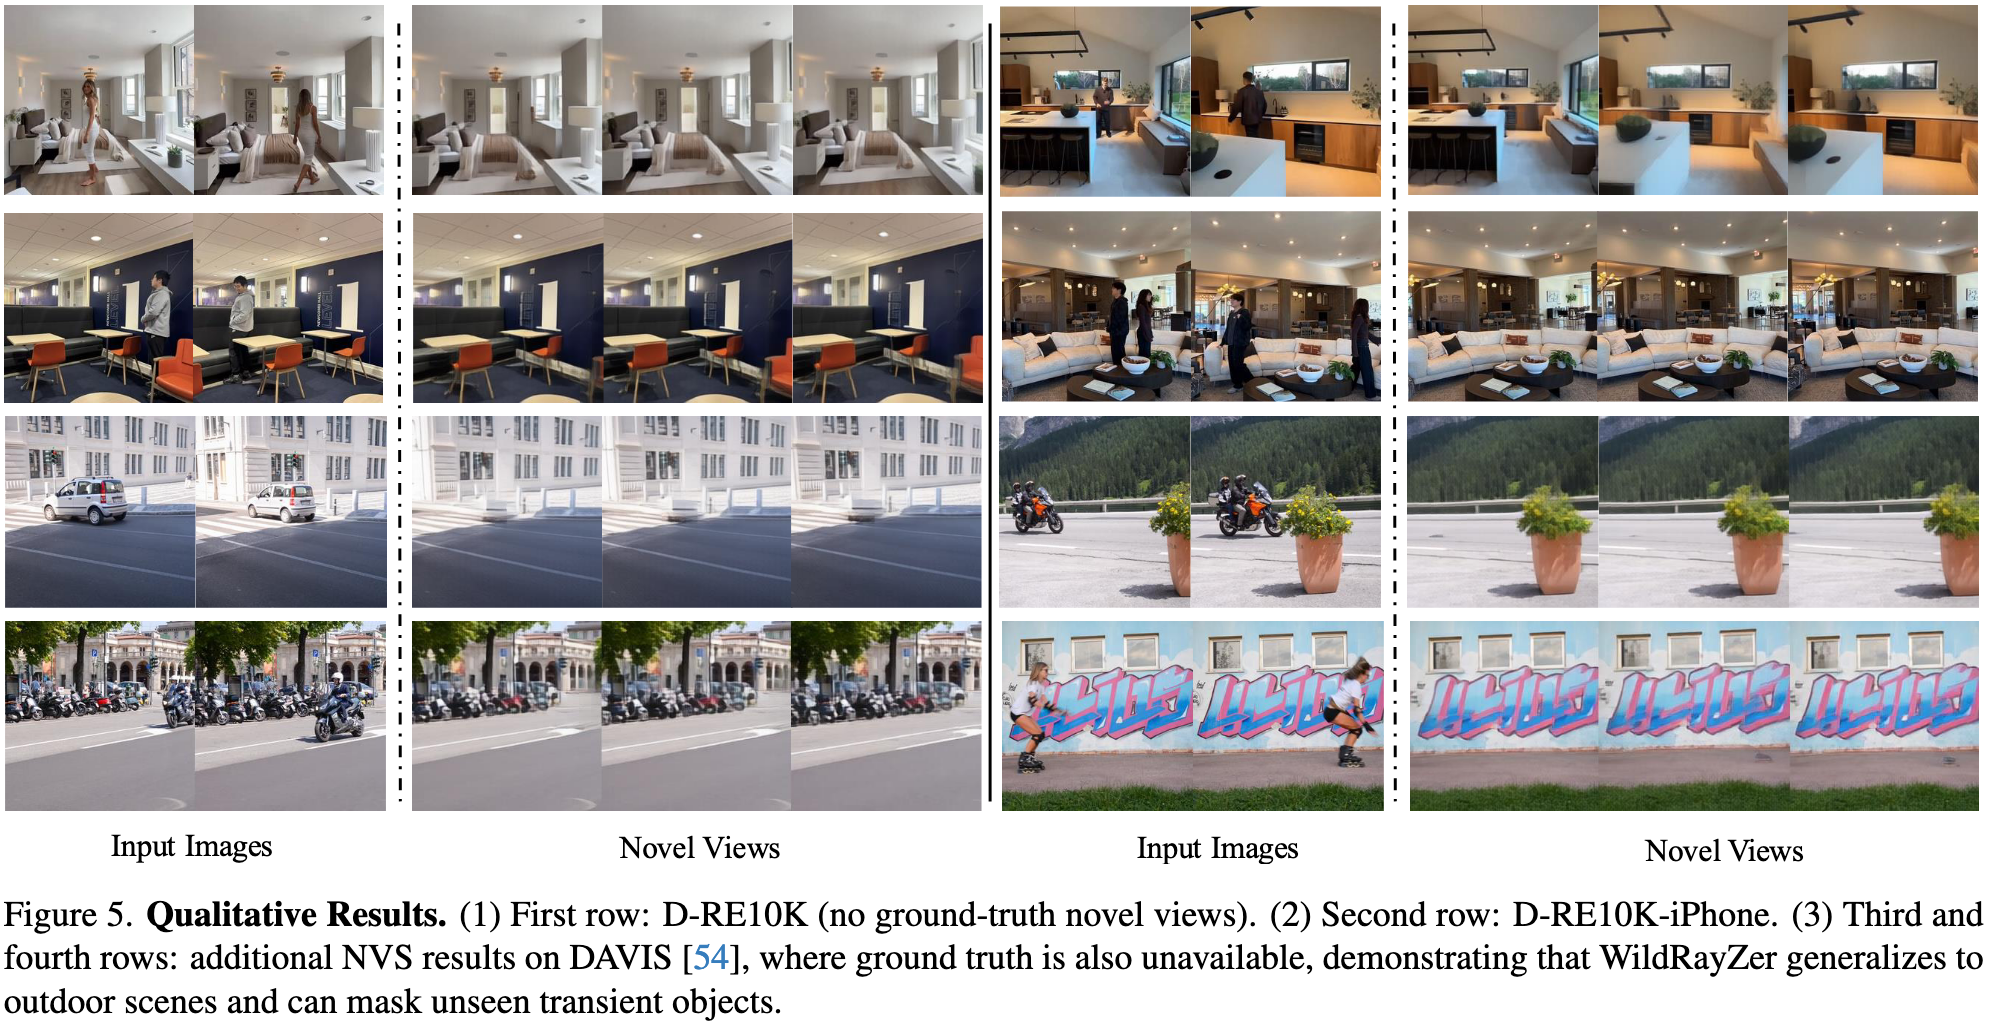
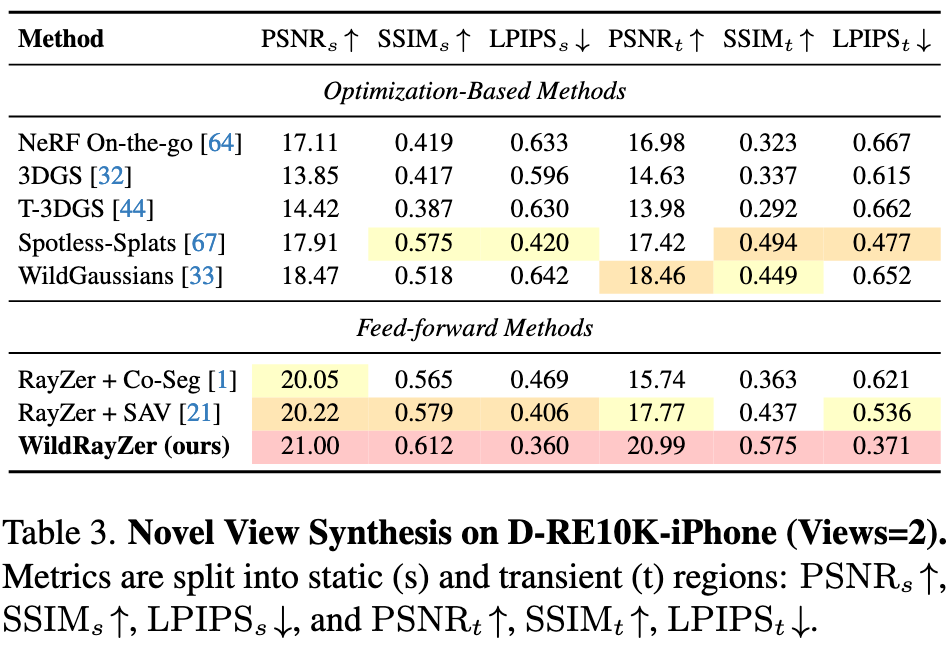

优势与不足
优势
- 完全自监督
- 拓展了自监督NVS在动态场景中的应用
不足
- 所预测的运动mask质量仍有待提高,对于特殊的纹理,如人影等仍然work得不好,部分分割与欠分割
- 并不算是真正的动态场景重建,并不能够将动态的物体重建出来
记忆点
- Unposed
- 用COCO数据集的物体标签直接复制粘贴到图像中,以增强模型对随机物体的鲁棒性
- DINOV3特征能够加快收敛,预测结果更加Sharp
 微信
 支付宝
相关推荐
2026-09-23
TokenGS: Decoupling 3D Gaussian Prediction from Pixels with Learnable Tokens
作者:Jiawei Ren, Michal Jan Tyszkiewicz, Jiahui Huang, Zan Gojcic 单位:NVIDIA 会议:CVPR 2026 Highlight(论文为 arXiv v1) 链接:arXiv:2604.15239 · Project Page · Code 研究动机很多前馈式 3DGS 模型按图像像素或 patch 预测高斯,并把中心表示成相机射线上的深度。这种参数化一方面把几何绑在输入像素和相机姿态上:位姿稍有噪声,多视图就可能彼此不一致;另一方面,高斯数量随分辨率和视图数一起增长。论文举例指出,32 张 512×512 图像按像素输出会超过 800 万个基元,其中不少只是重复覆盖同一场景。直接在测试时优化所有高斯参数也可能破坏预训练模型带来的几何先验。 TokenGS 保留前馈推理,但改变输出端的“单位”:不再为像素分配高斯,而是让一组 learnable Gaussian tokens 直接回归共享场景坐标中的三维中心,再由每个 token...
2026-06-15
2DGS: 2D Gaussian Splatting for Geometrically Accurate Radiance Fields
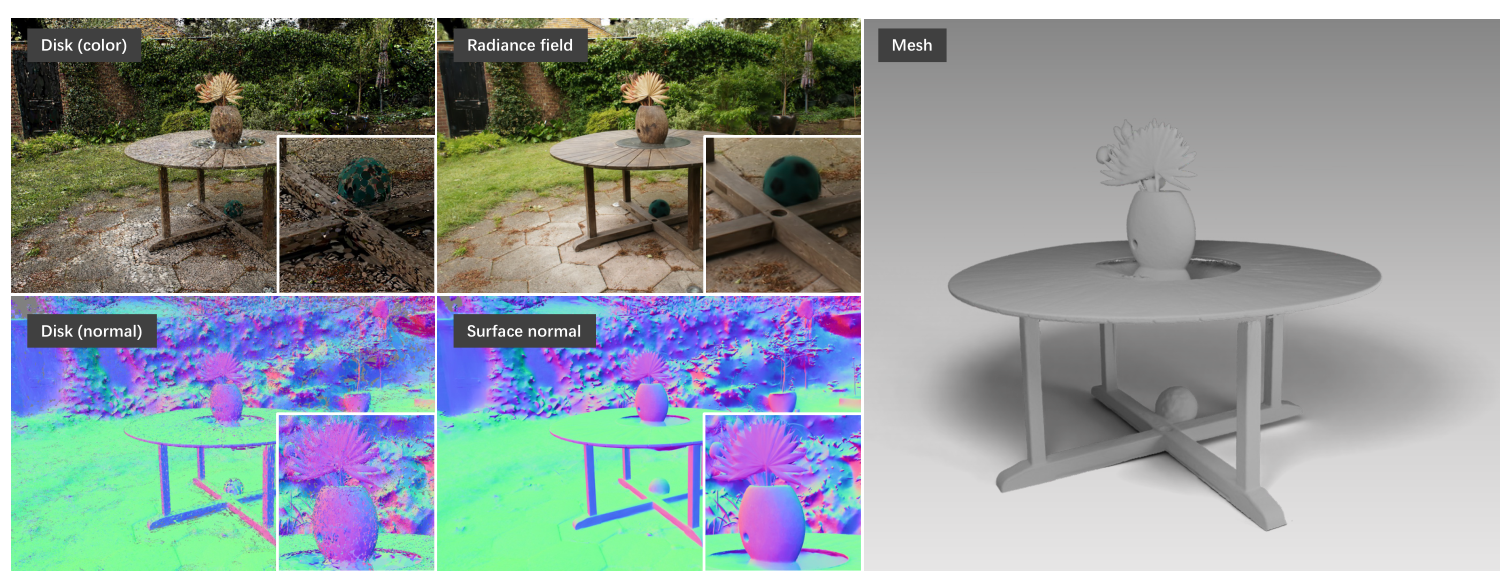
作者:Binbin Huang, Zehao Yu, Anpei Chen, Andreas Geiger, Shenghua Gao 单位:ShanghaiTech University, University of Tübingen, Tübingen AI Center 会议:SIGGRAPH 2024 Conference Papers 链接:arXiv, Project, Code 研究动机 3D Gaussian Splatting 的吸引力在于它把新视角合成做到了高质量、快速训练和实时渲染,但它的几何表达并不天然适合表面重建。3DGS 的基本单元是三维体素状 Gaussian blob,它可以很好地拟合视图相关外观,却会在几何上产生一个矛盾:真实世界的许多物体表面是薄的二维流形,而 3D Gaussian 表示的是有体积的密度分布。颜色可以通过体渲染被拟合出来,但表面在哪里、法向是否一致、不同视角看到的交点是否稳定,并没有被表示方式直接约束。 这篇文章要解决的问题不是单纯提升 PSNR,而是把 Gaussian Splatting...
2026-07-24
MetaView: Monocular Novel View Synthesis with Scale-Aware Implicit Geometry Priors
作者:Yufei Cai, Xuesong Niu, Hao Lu, Kun Gai, Kai Wu, Guosheng Lin 单位:Nanyang Technological University, Kolors Team at Kuaishou Technology, The Hong Kong University of Science and Technology (Guangzhou) 会议:ECCV 2026 链接:论文 | 项目页 | 代码 研究动机单张图像的新视角合成同时面对两个互相牵制的目标:一方面,输出必须遵守相机运动和场景几何;另一方面,当视角变化很大、目标视图出现源图不可见区域时,模型又必须依靠生成先验补全内容。 已有扩散式方法大致分为两类。显式几何路线先重建点云或网格,再把重投影结果交给扩散模型补洞;它的局部对应关系较可靠,但错误深度、稀疏重建和遮挡会被直接传入生成阶段。纯隐式路线只给生成模型相机位姿,保留了强大的开放域生成能力,却容易出现“相机走了、场景尺度也跟着漂移”的问题。 MetaView...
2026-05-14
RoSplat: Robust Feed-Forward Pixel-wise Gaussian Splatting for Varying Input Views and High-Resolution Rendering
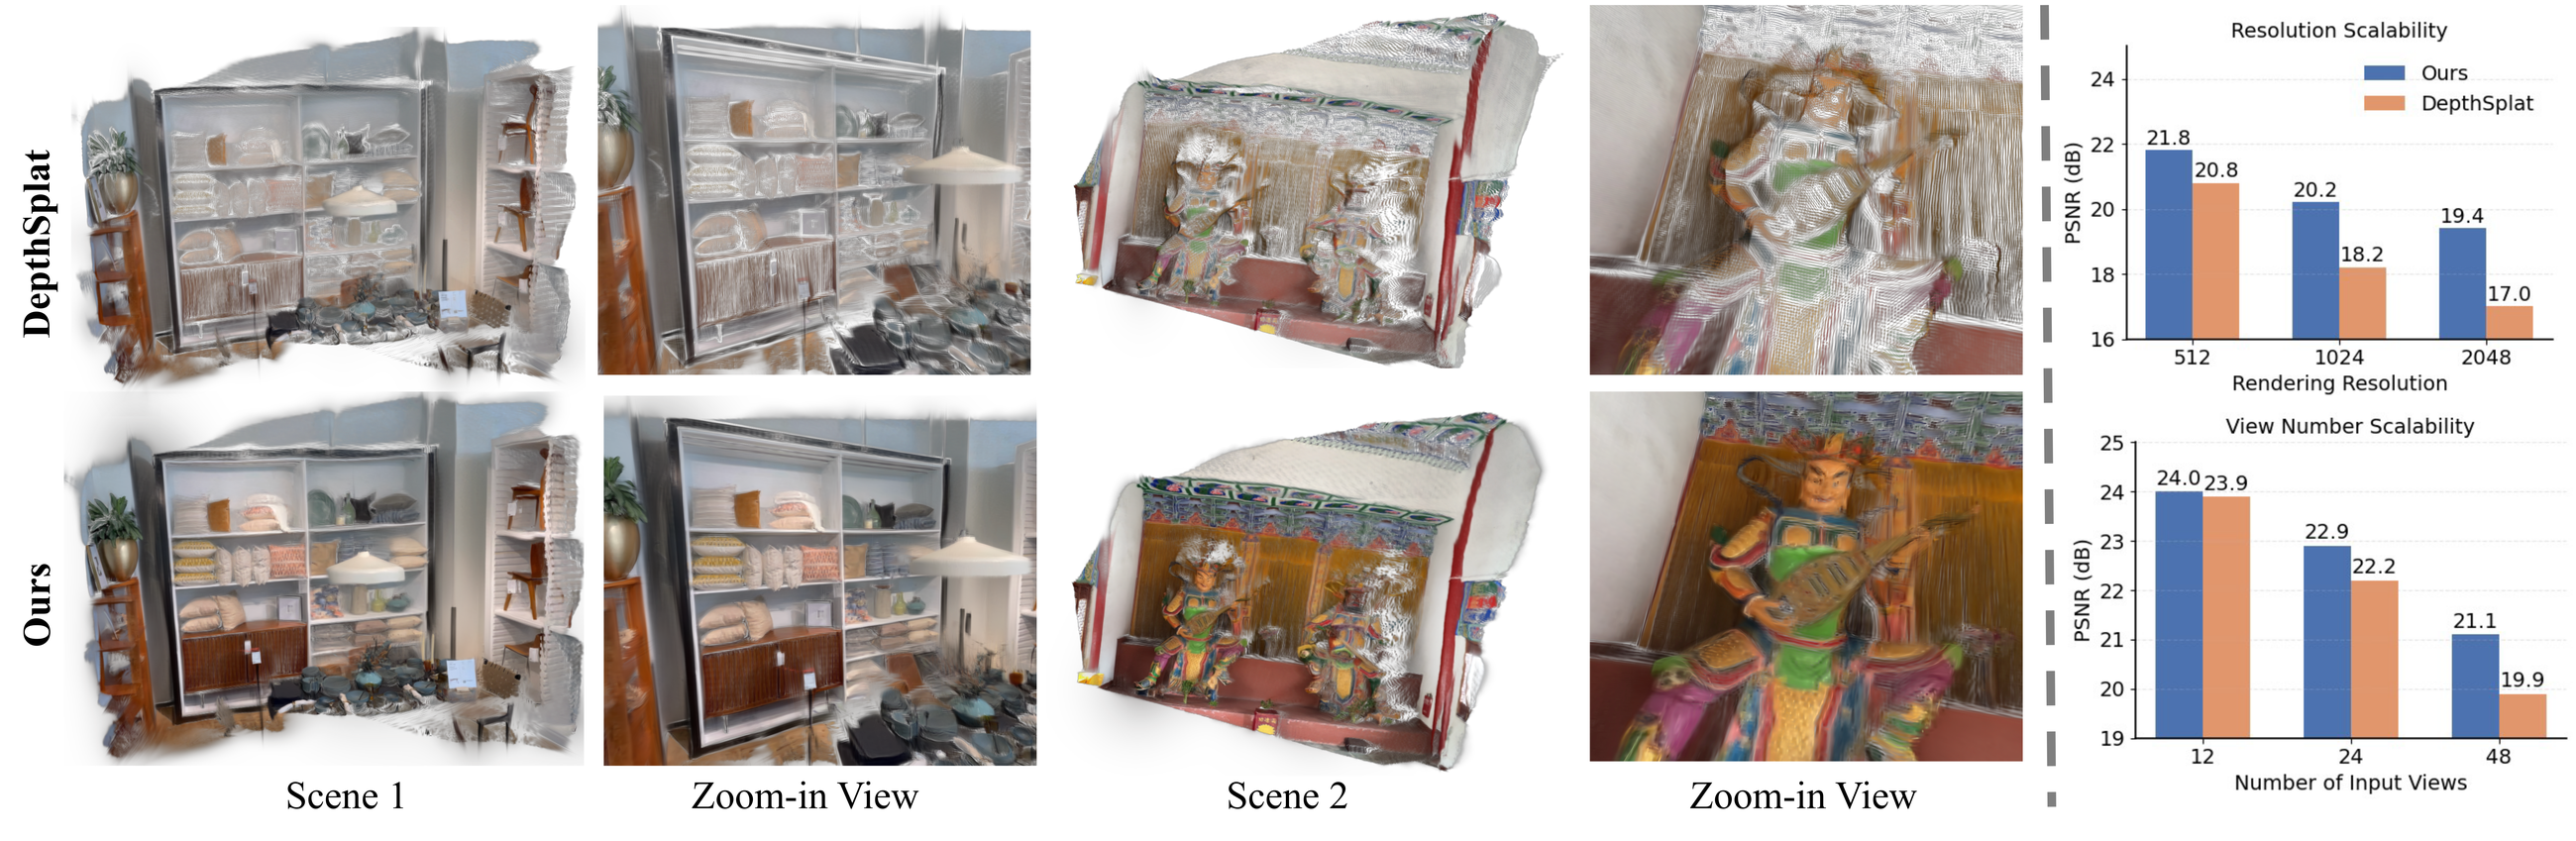
作者:Hoang Chuong Nguyen, Renjie Wu, Jose M. Alvarez, Miaomiao Liu 单位:Australian National University; NVIDIA 会议:2026 Arxiv 链接:https://arxiv.org/abs/2605.13093 研究动机 Generalizable 3D Gaussian Splatting 的目标是跳过 per-scene optimization,用少量输入视角直接前馈预测一组 pixel-wise Gaussians,然后完成 novel view synthesis。PixelSplat、MVSplat、DepthSplat、TranSplat 等方法已经证明了这条路线的效率和泛化潜力。 但这篇论文指出,现有 pixel-wise feed-forward GS 有两个很实际的问题。 输入视角数变化会导致过亮。很多模型训练时只用固定数量的输入视角,例如 RealEstate10K 上常用 2 views;测试时如果给 4/8/16 views,同一 3D...
2026-08-31
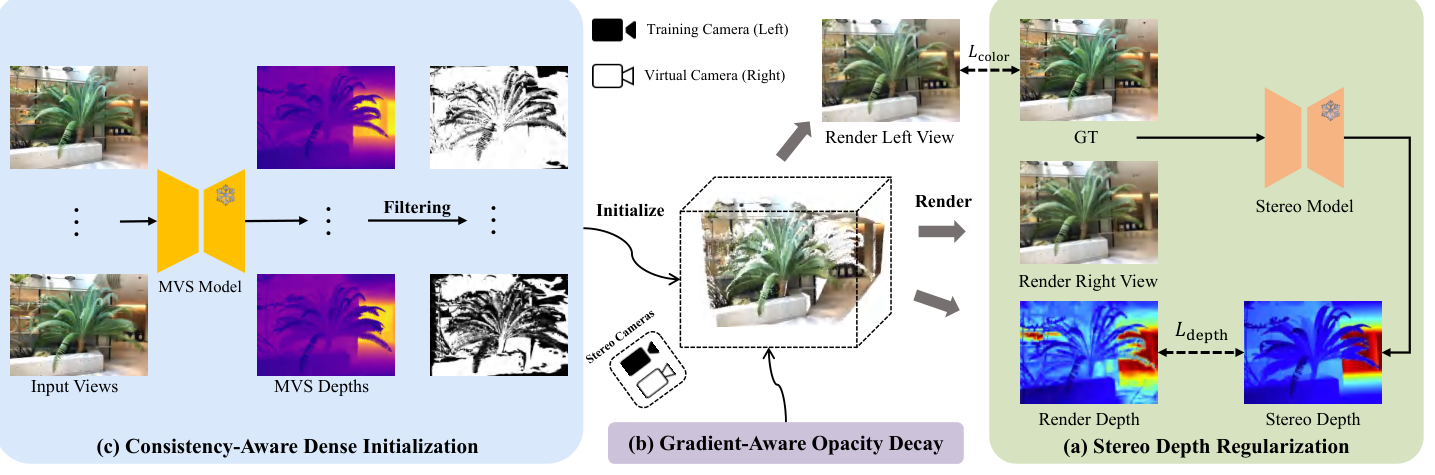
StereoGS: Sparse-View 3D Gaussian Splatting via Stereo Priors
作者: Wenhao Yuan, Yiyuan Ge, Deli Cai 单位: South China University of Technology 会议: ECCV 2026 链接: arXiv | Project | Code 研究动机Sparse-view 3DGS 的根本困难不是 renderer 不够强,而是 几何约束太弱。只有少量训练视角时,很多错误的 Gaussian geometry 仍然可以很好地拟合训练 RGB,因此优化很容易出现 overfitting、floaters、错误表面和 novel-view artifacts。 已有方法常用 monocular depth prior 缓解这个问题,但 StereoGS 认为 MDE 在这里有两个天然缺陷: scale ambiguity:单目 depth 的尺度与 3DGS 世界坐标不天然一致; cross-view inconsistency:每个视角独立推理,同一真实 3D point 在不同图像中的 depth 可能不一致。 即使先用 MVS 获得一个更好的...
2026-09-23
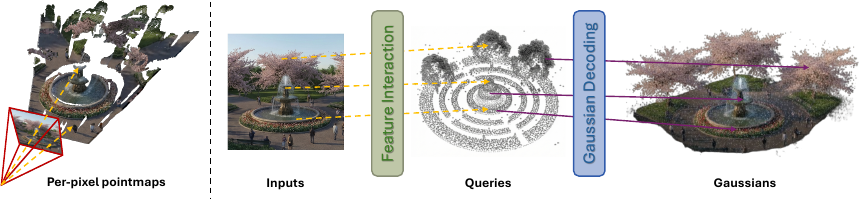
UniQueR: Unified Query-based Feedforward 3D Reconstruction
作者:Chensheng Peng, Quentin Herau, Jiezhi Yang, Yichen Xie, Yihan Hu, Wenzhao Zheng, Matthew Strong, Masayoshi Tomizuka, Wei Zhan 单位:Applied Intuition, University of California, Berkeley, Stanford University 会议:ECCV 2026(收录;论文为 arXiv v2) 链接:arXiv:2603.22851 · Project Page · ECCV 2026 Accepted Papers 研究动机前馈式三维重建已经能从少量图像一次性预测点图或 3D Gaussian Splatting(3DGS),但常见做法仍是“每个像素对应一批三维基元”:几何沿相机射线组织,天然只覆盖输入图像看见的表面。换到遮挡区域或输入视角之外时,模型缺少主动分配几何的自由度,容易留下空洞。UniQueR...
评论
最新文章