TokenGS: Decoupling 3D Gaussian Prediction from Pixels with Learnable Tokens
作者:Jiawei Ren, Michal Jan Tyszkiewicz, Jiahui Huang, Zan Gojcic
单位:NVIDIA
会议:CVPR 2026 Highlight(论文为 arXiv v1)
链接:arXiv:2604.15239 · Project Page · Code
研究动机
很多前馈式 3DGS 模型按图像像素或 patch 预测高斯,并把中心表示成相机射线上的深度。这种参数化一方面把几何绑在输入像素和相机姿态上:位姿稍有噪声,多视图就可能彼此不一致;另一方面,高斯数量随分辨率和视图数一起增长。论文举例指出,32 张 512×512 图像按像素输出会超过 800 万个基元,其中不少只是重复覆盖同一场景。直接在测试时优化所有高斯参数也可能破坏预训练模型带来的几何先验。
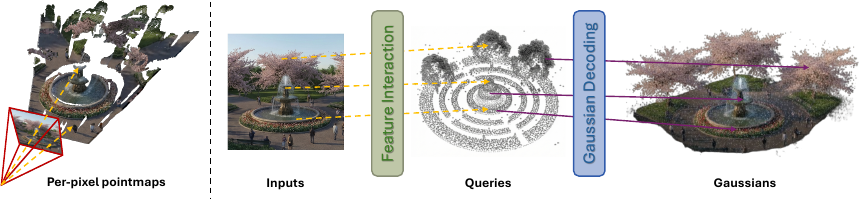
TokenGS 保留前馈推理,但改变输出端的“单位”:不再为像素分配高斯,而是让一组 learnable Gaussian tokens 直接回归共享场景坐标中的三维中心,再由每个 token 解码局部高斯簇。这样,高斯数量可以作为模型容量旋钮,而不是输入图像分辨率的副产物。
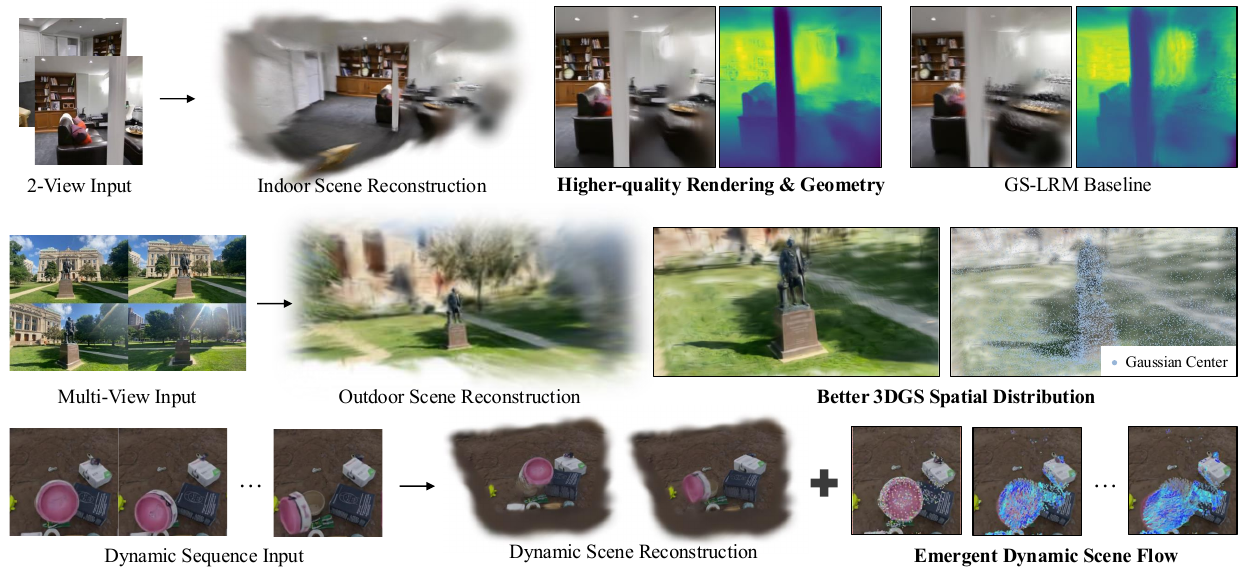
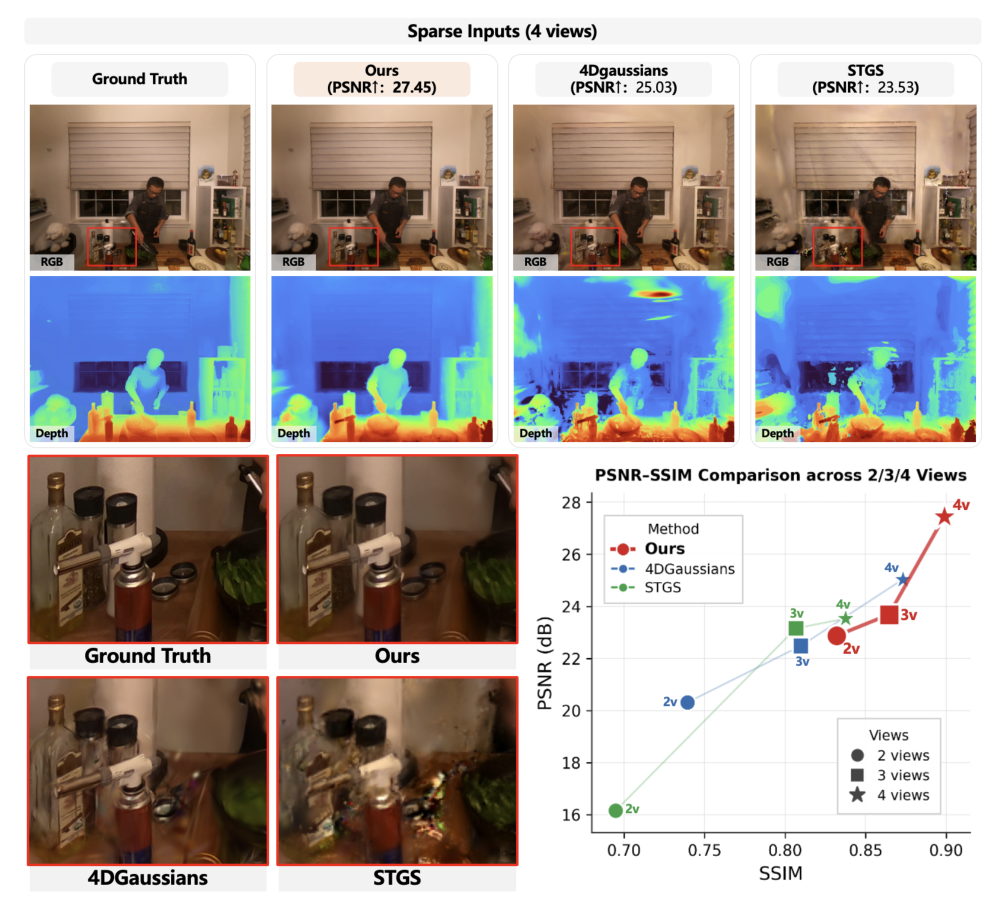
图 1 汇总了论文展示的几类能力:静态室内/室外重建、较均衡的高斯空间分布,以及动态序列中的运动建模与场景流。与 UniQueR 不同,TokenGS 的实验输入带有相机位姿;它解耦的是高斯中心与像素射线,并不是一个无位姿输入方法。
核心方法
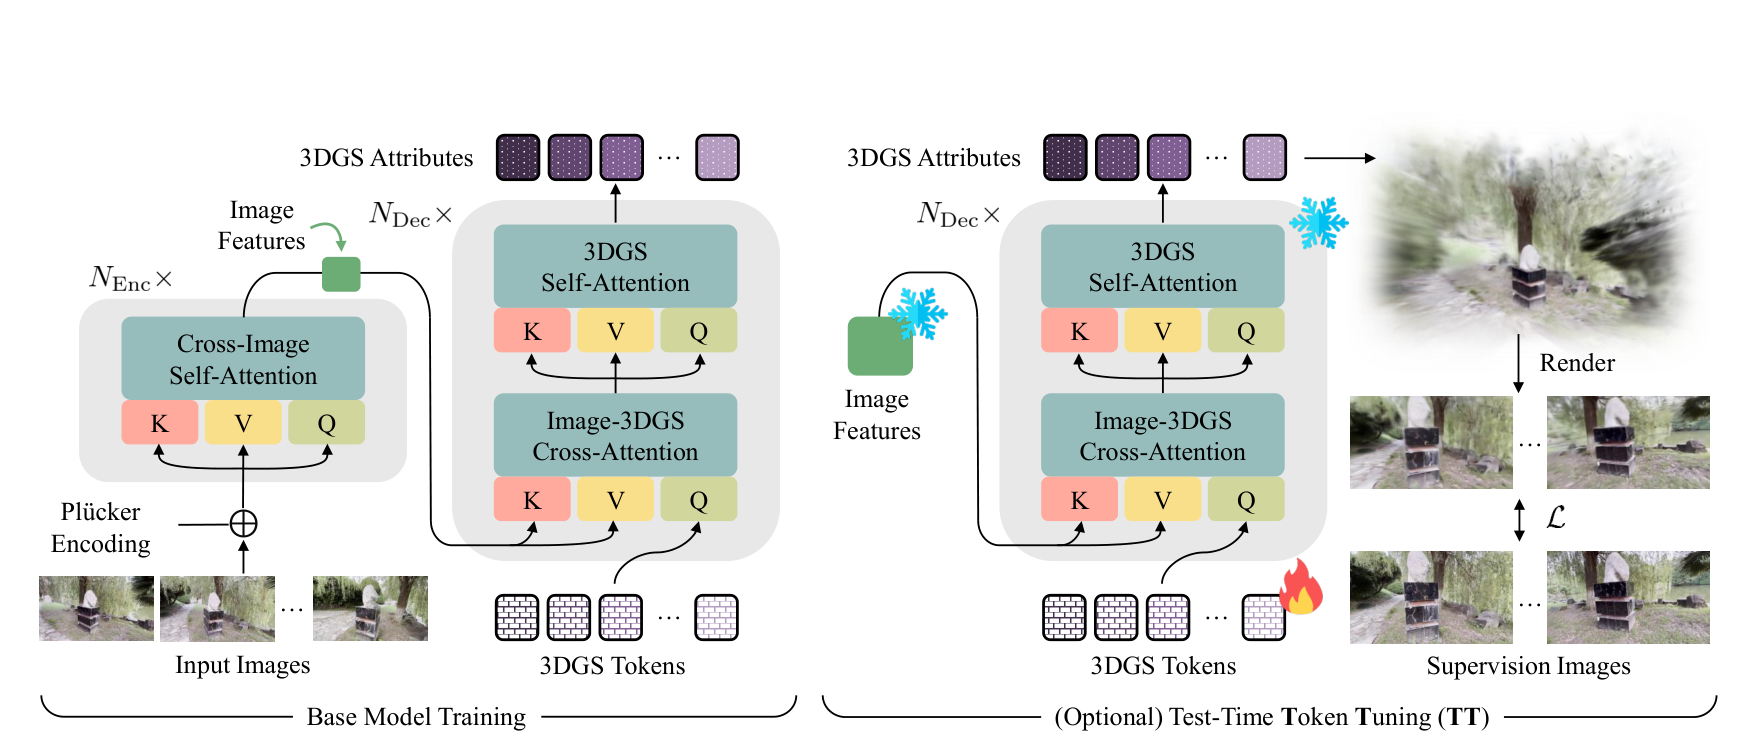
从图像 token 解码 Gaussian token。 输入是带外参的多视图图像。ViT 编码器把图像 patch 与相应的 Plücker 射线位置信息编码为图像 token;Transformer 解码器则接收一组可学习的高斯 token,先对图像 token 做交叉注意力,再在高斯 token 之间自注意力。每个输出 token 预测一组 3DGS 属性,包括直接回归的 XYZ 中心、颜色、不透明度、尺度和旋转。论文的默认 token 可各生成 64 个高斯:1024 个 token 对应约 66K 个高斯,4096 个 token 对应 262K。
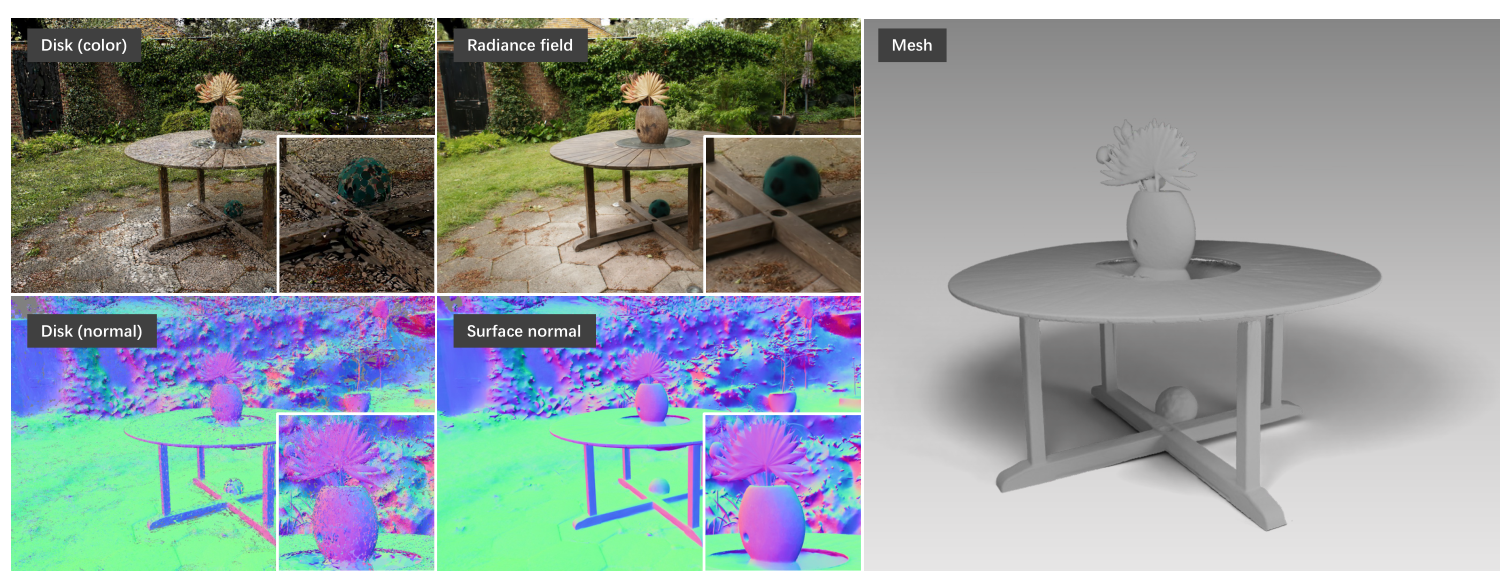
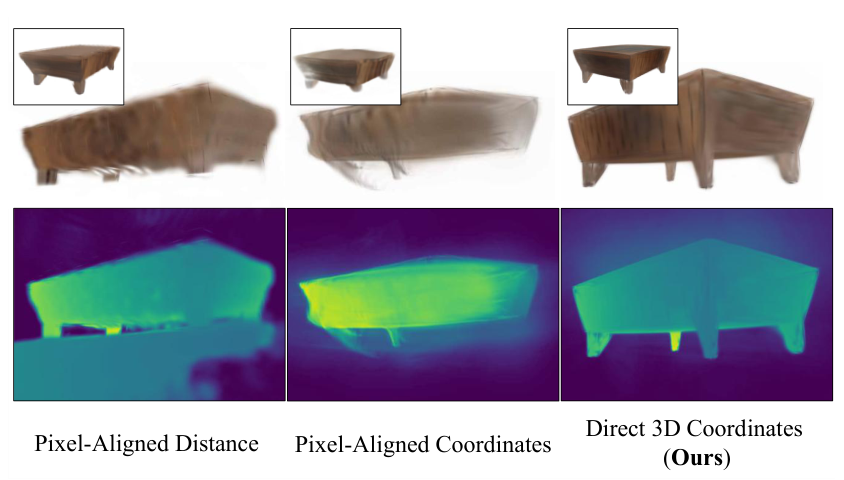
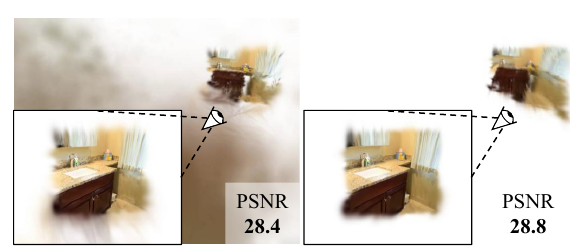
与像素对齐的深度/坐标参数化相比,直接 XYZ 预测让中心可以离开相机射线,从而能把基元放到遮挡或视角外的场景部分。图 3 的单物体示例强调,几种表示都能拟合输入视图,但对不可见区域的几何延伸不同。这个训练不需要点图真值:模型把高斯渲染到监督视图,使用图像重建损失和可见性正则化。可见性项惩罚那些中心落在所有监督视图画面之外、因而无法收到正常渲染梯度的高斯,以减少漂浮点与无效容量。
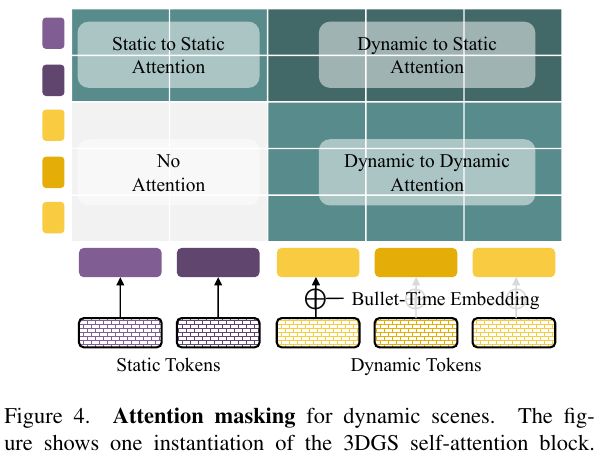
动态场景由静态与动态 token 分工。 动态版本将 token 划分为时间不变的静态部分和带时间条件的动态部分。动态 token 加入目标时间戳(论文称 bullet-time)的嵌入,并采用结构化注意力掩码,使运动部分能够依赖静态场景结构,同时保持跨时间的一致对应。图 4 示意注意力分区;图 8、图 9 则分别展示中间时间戳渲染和动态高斯轨迹。
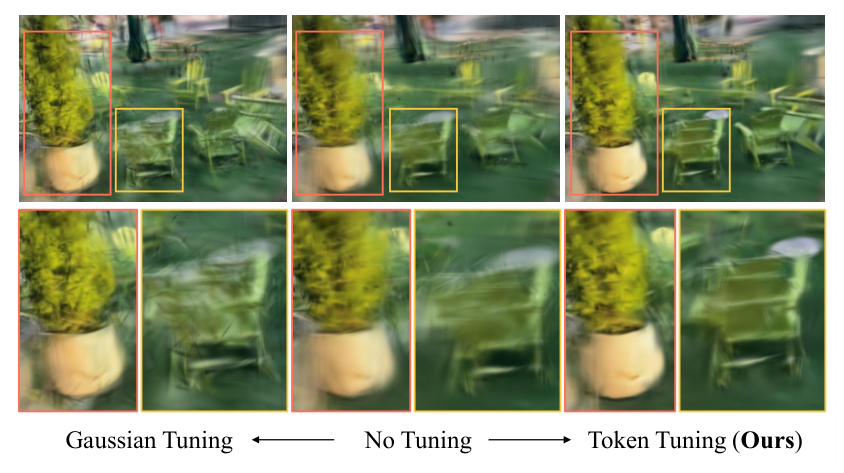
测试时扩展不必改网络权重。 论文给出两个互补策略:一是 context extension,测试时加入比训练时更多的输入视图,但高斯数量不随视图数改变;二是 token tuning,只优化当前场景的高斯 token embedding,冻结网络权重和图像特征。这样做是希望在适应场景的同时保留 decoder 学到的先验,而不是直接把全部高斯自由拟合到少数输入图像上。
数据集
静态场景评估包括 RealEstate10K(双视图重建、位姿噪声、视角外推)和 DL3DV(2、4、6 视图的上下文长度泛化与视角外推)。DL3DV 的 4-view 是论文报告的训练视图数,2-view 和 6-view 用于测试 context extension。动态实验使用 Kubric 4D:以在 RealEstate10K 与 DL3DV 上训练的 4-view 基础模型为起点,增加 256 个动态高斯 token 并在 Kubric 上微调,最终在 16 个 held-out 场景上评估。
算力
静态基础模型采用 6 层编码器、24 层解码器,通道维度 1024;为了在 DL3DV 上测试更高分辨率和更多视图,论文还使用 3 层编码器、12 层解码器的设置。训练 batch size 为 64,使用 8 张 NVIDIA A100:先以 1024 个 Gaussian token、256×256 分辨率训练 150K 次迭代,再以 4096 个 token 微调 10K 次。DL3DV 微调分辨率为 448×256。作者报告基础训练约 36 小时,微调通常约 4 小时,具体取决于 token 数和分辨率。
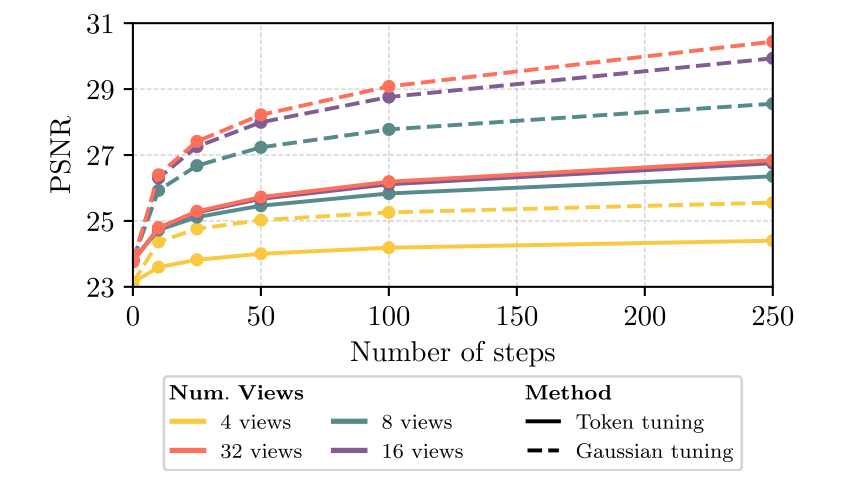
测试时 token tuning 默认 50 步、学习率 $10^{-4}$;论文也在实验中扫描更多步数。动态 Kubric 阶段另以 256 个动态 token 微调 50K 次。
实验结果
双视图重建与基元预算。 RealEstate10K 的表 1 中,1024-token 模型只用约 66K 个高斯便达到 28.02 PSNR / 0.896 SSIM;4096-token 微调版达到 28.41 / 0.903,加入 token tuning 后为 28.82 / 0.910 / 0.130(PSNR / SSIM / LPIPS,262K 高斯)。这说明 token 数可以独立控制压缩与质量;基线仍可能在某些指标上有优势,例如表中 MVSplat 的 LPIPS 为 0.128。
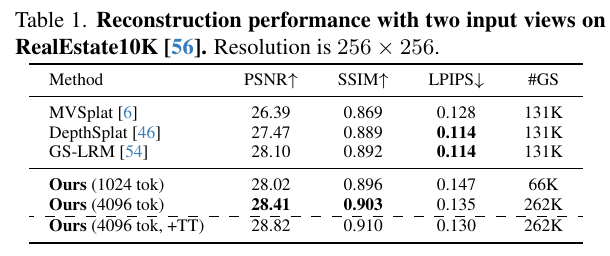
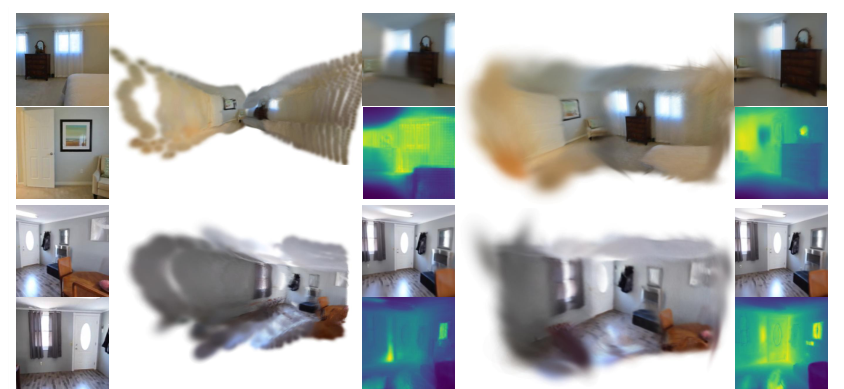
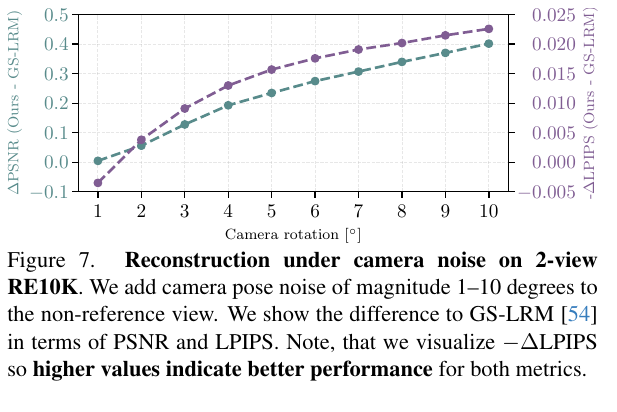
图 5 的 RE10K 可视化展示了与 GS-LRM 的对比:TokenGS 直接预测 XYZ 后,几何尖刺较少。图 7 进一步在第二个输入相机加入 1–10 度旋转噪声,并画出相对 GS-LRM 的 PSNR 与 LPIPS 差值;随着噪声增大,TokenGS 的相对优势扩大,支持“中心不被射线硬约束会更抗位姿误差”的解释。
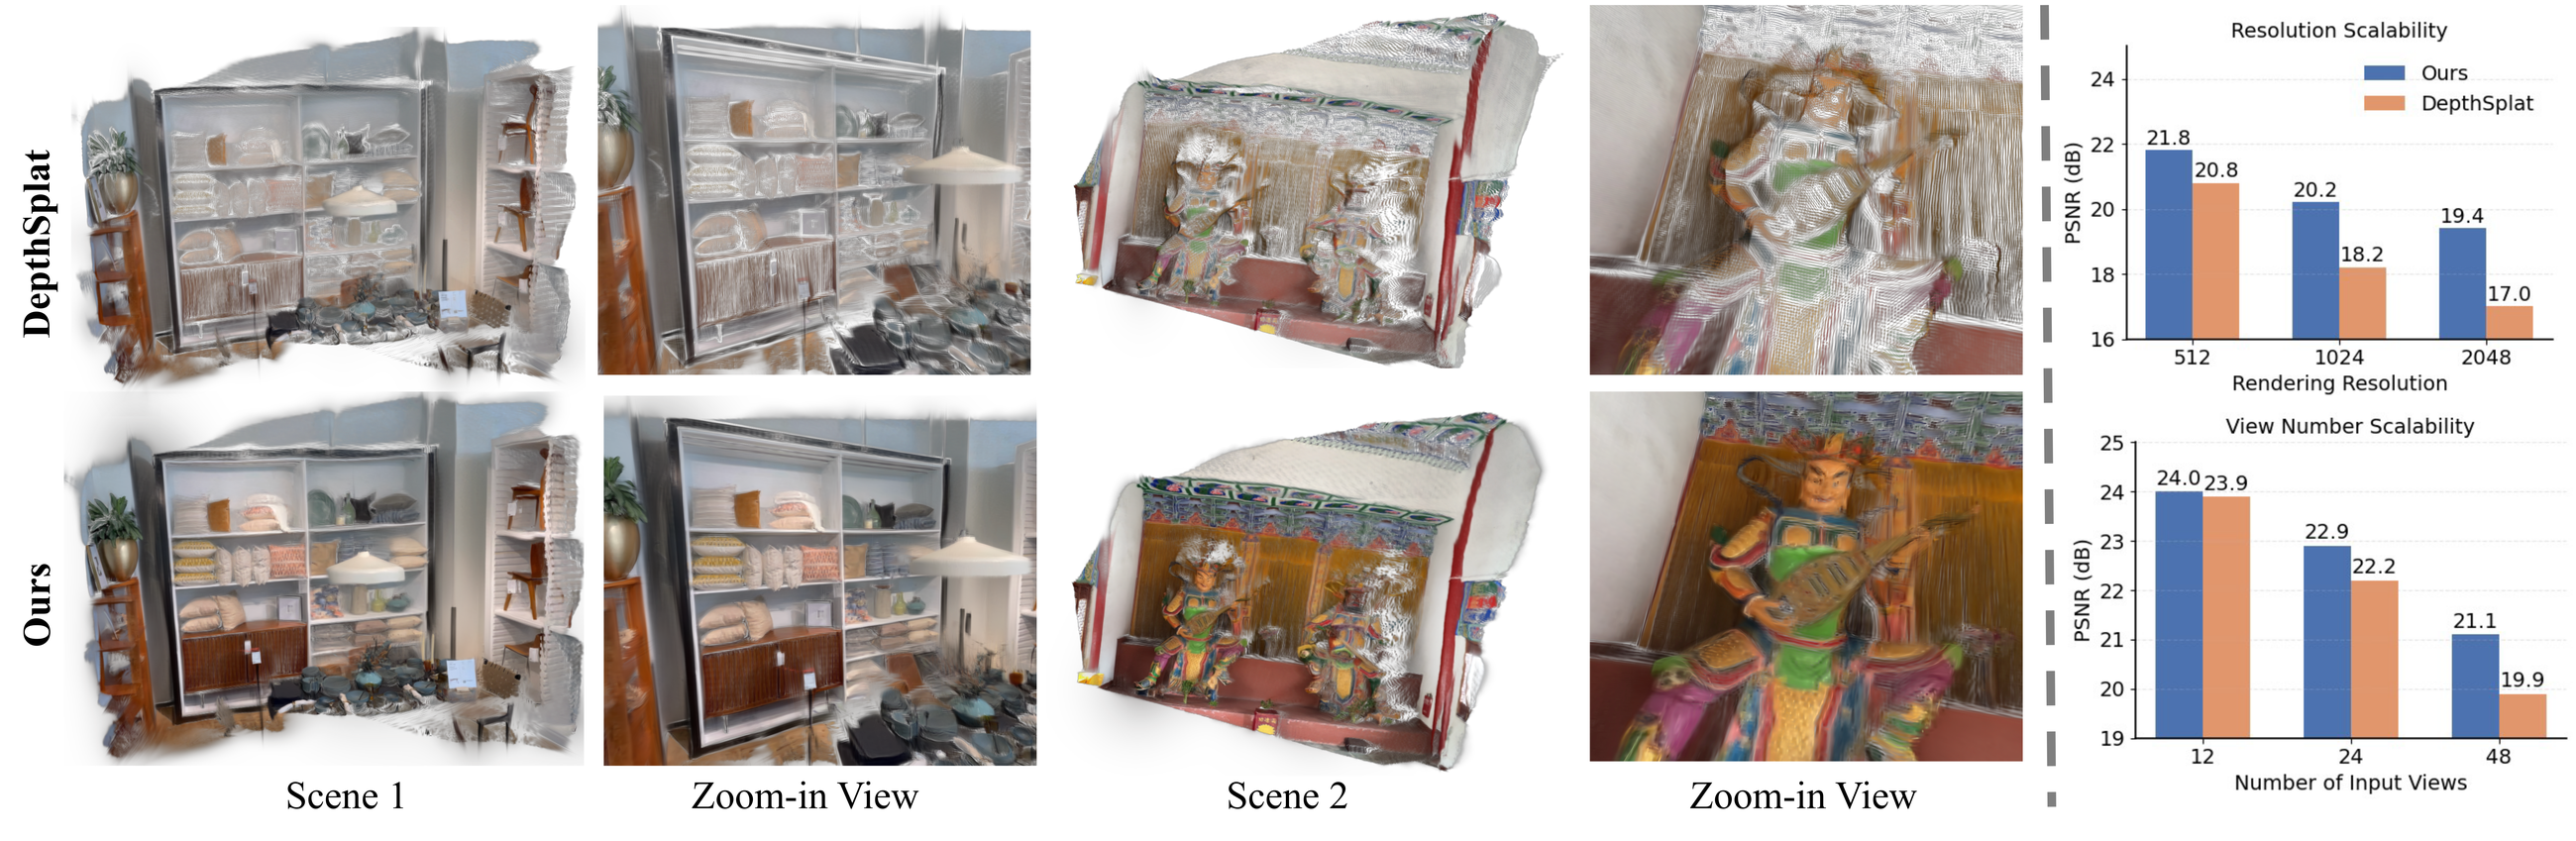
视图数扩展与视角外推。 DL3DV 表 2 中,4-view 训练的模型无需重新训练即可用于 2-view、6-view。6-view 加 token tuning 时,PSNR 达到 24.51,使用 262K 高斯;DepthSplat 为 24.19,但用了 688K 高斯。不过 DepthSplat 的 SSIM / LPIPS 更好(0.823 / 0.147,对比 TokenGS 的 0.792 / 0.295)。所以结果说明的是更灵活的预算与 PSNR 取舍,不是所有图像质量指标都胜出。
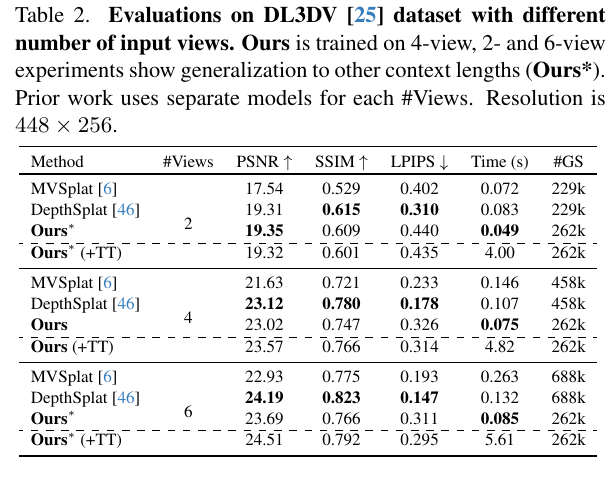
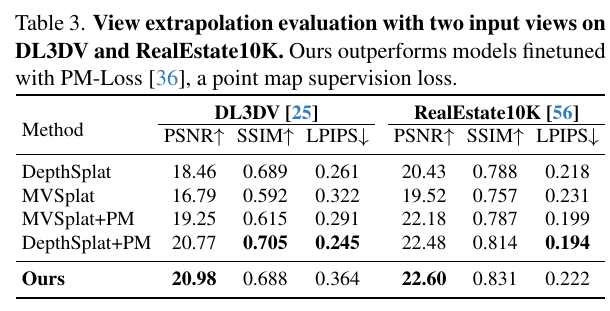
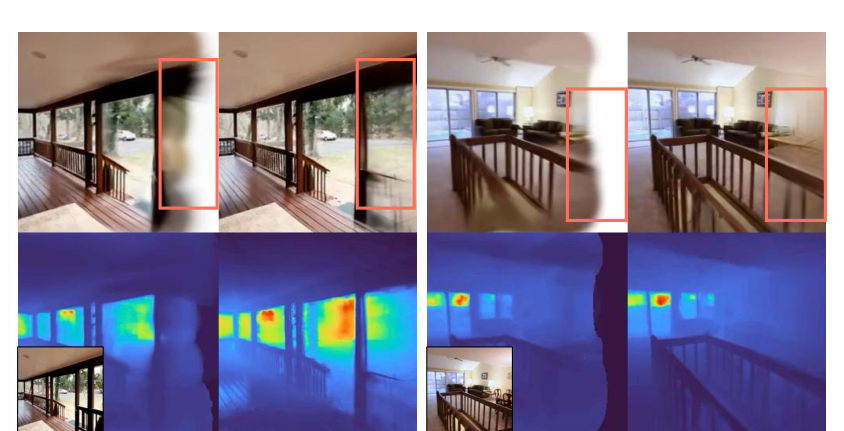
表 3 将目标视图放到输入上下文之外。TokenGS 在 DL3DV 与 RealEstate10K 上的 PSNR 分别为 20.98 和 22.60,均高于表中对照;但在 DL3DV 的 SSIM、LPIPS 上仍落后于带 point-map supervision 的 DepthSplat+PM,在 RealEstate10K 上 LPIPS 也不是最佳。图 6 的定性例子显示,直接 3D 坐标预测有助于把几何延伸到输入相机未覆盖的边界区域。
动态重建。 Kubric 4D 表 4 中,TokenGS 的 PSNR 为 24.84,高于 BTimer 的 24.45;但 TokenGS 的 SSIM / LPIPS 为 0.821 / 0.287,低于 BTimer 的 0.835 / 0.162。图 8 展示中间时间戳渲染,图 9 可视化动态高斯的轨迹,支持其能显式跟踪运动的主张;定量结果则是 PSNR 与感知指标之间有明显取舍。
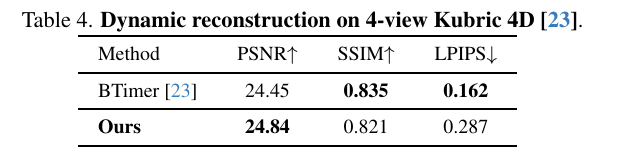
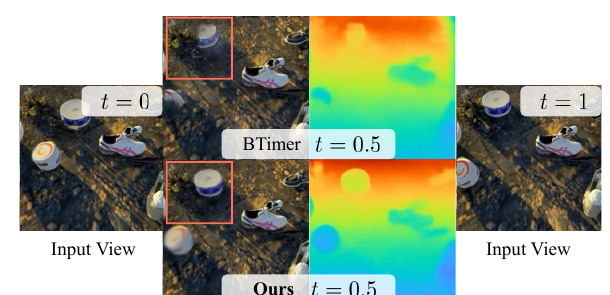
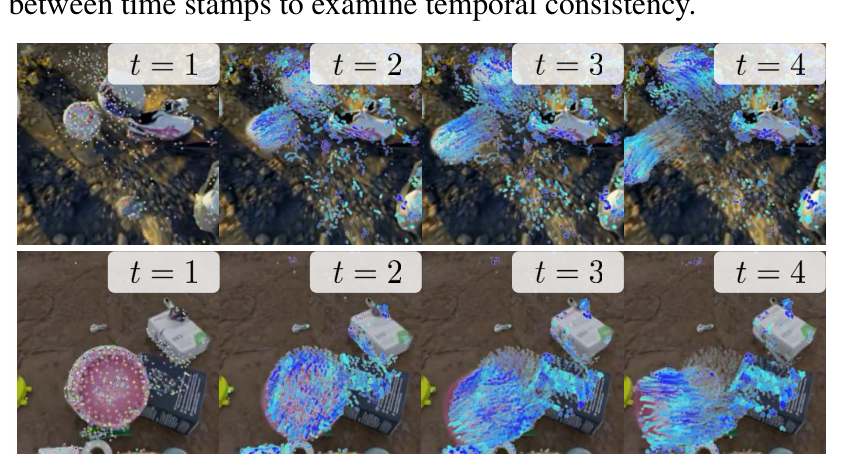
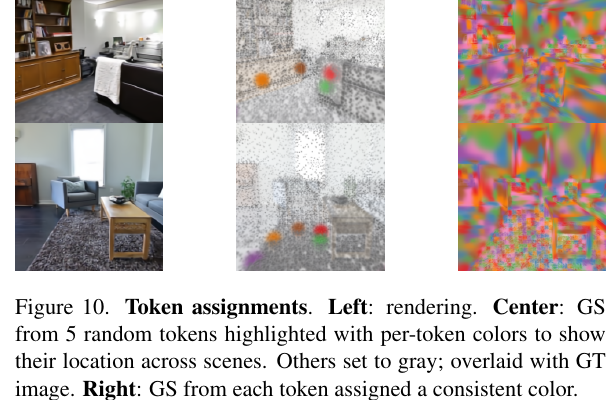
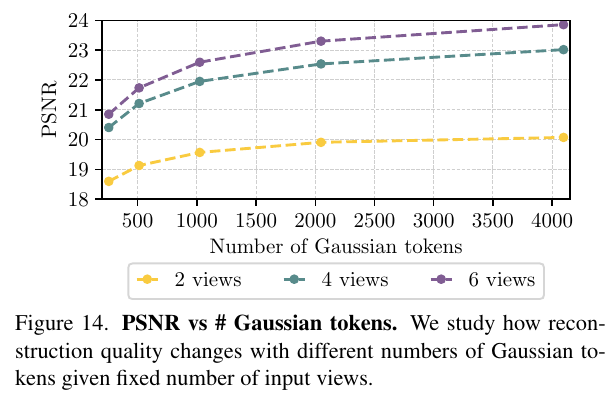
图 10 展示不同 token 的空间分配:单个 token 的高斯倾向于聚集在场景局部,不同 token 也呈现一定的功能分工。附录图 11 消融可见性损失,作者报告该正则带来约 0.4 PSNR 改善并减少不可见区域的漂浮物;图 12 展示增加输入视图或 token tuning 步数的测试时扩展。图 13 对比直接优化 Gaussian 参数与优化 token embedding:前者可能以近邻视图的数值提升为代价损害几何,后者的视觉结构更稳定。图 14 则显示固定视图数下,增加 Gaussian token 通常可提高 PSNR。
优势与不足
优势
- 直接回归规范坐标中的高斯中心,避免把每个中心锁定在某个输入像素的相机射线上,也不依赖点图真值监督。
- Gaussian token 数独立于输入像素数与视图数,提供清楚的压缩—质量控制旋钮。
- token tuning 只调整场景 token embedding,冻结预训练网络和图像特征;结合更多上下文视图时,无需训练多套不同视图数模型。
- 静态、动态实验共享 token 解码框架,动态 token 可通过时间条件表达运动并形成可视化场景流。
不足
- 输入需要相机外参;相较无位姿前馈重建,它解决的是输出表示受像素射线束缚的问题,并未消除相机标定/位姿依赖。
- 结果不是全面的指标胜出:动态 Kubric 的 SSIM、LPIPS 明显落后 BTimer;视图数扩展与外推实验中也存在 PSNR、SSIM、LPIPS 之间的权衡。
- 作者承认大尺度环境和精细几何仍困难;token tuning 需要额外几十步测试时优化,虽然比全高斯优化更受先验约束,但仍增加推理成本。
记忆点
- 固定 token 数,改变场景密度: 表示预算由模型输出端决定,而不是被输入分辨率和图像数量自动放大。
- 解耦不等于免标定: TokenGS 不让高斯中心跟随像素射线,但仍以相机位姿编码输入几何。
- 测试时更新“压缩后的场景状态”: 只调 token embedding,试图让新视图适配与已学几何先验同时保留。
 微信
 支付宝