UniQueR: Unified Query-based Feedforward 3D Reconstruction
作者:Chensheng Peng, Quentin Herau, Jiezhi Yang, Yichen Xie, Yihan Hu, Wenzhao Zheng, Matthew Strong, Masayoshi Tomizuka, Wei Zhan
单位:Applied Intuition, University of California, Berkeley, Stanford University
会议:ECCV 2026(收录;论文为 arXiv v2)
链接:arXiv:2603.22851 · Project Page · ECCV 2026 Accepted Papers
研究动机
前馈式三维重建已经能从少量图像一次性预测点图或 3D Gaussian Splatting(3DGS),但常见做法仍是“每个像素对应一批三维基元”:几何沿相机射线组织,天然只覆盖输入图像看见的表面。换到遮挡区域或输入视角之外时,模型缺少主动分配几何的自由度,容易留下空洞。UniQueR 问的是:能否不用逐像素输出,而用一组数量固定、直接位于三维场景坐标中的查询,让它们从多视图特征取证据,再生成可渲染的场景?
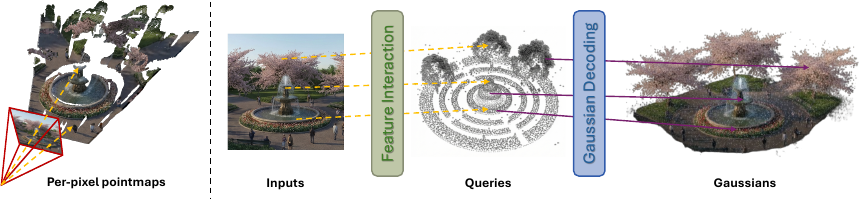
图 1 对比了像素对齐管线与查询式表示:输入图像先为全局 3D queries 提供信息,查询再在共享场景坐标中生成高斯,而不必把所有几何限制在已有像素射线上。需要注意,UniQueR 的输入是未标定图像,但网络仍会内部预测相机姿态;“未标定”不等于完全不估计相机。
核心方法
先估计几何,再让查询补充几何。 对每幅输入图像,视觉主干提取图像 token,并预测相机到世界变换、局部点图和置信度。主干以 DINOv2 与 Pi3 初始化的交替注意力几何网络为基础;论文冻结了大型图像/几何部分,训练相机头、查询 Transformer 和高斯生成头。所有相机、点图与后续高斯被放进同一个每场景坐标规约中。这个规约是非度量的,也不是简单地把第一帧当作世界原点;统一的相似变换不影响渲染监督,因此方法不应被解读成恢复带公制尺度的地图。
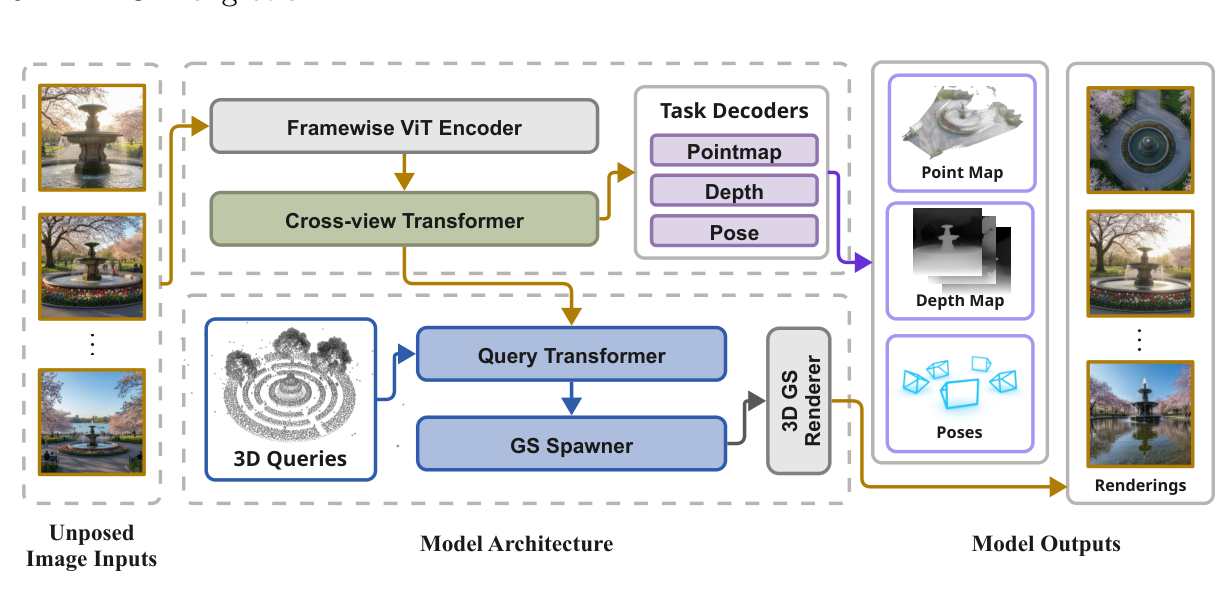
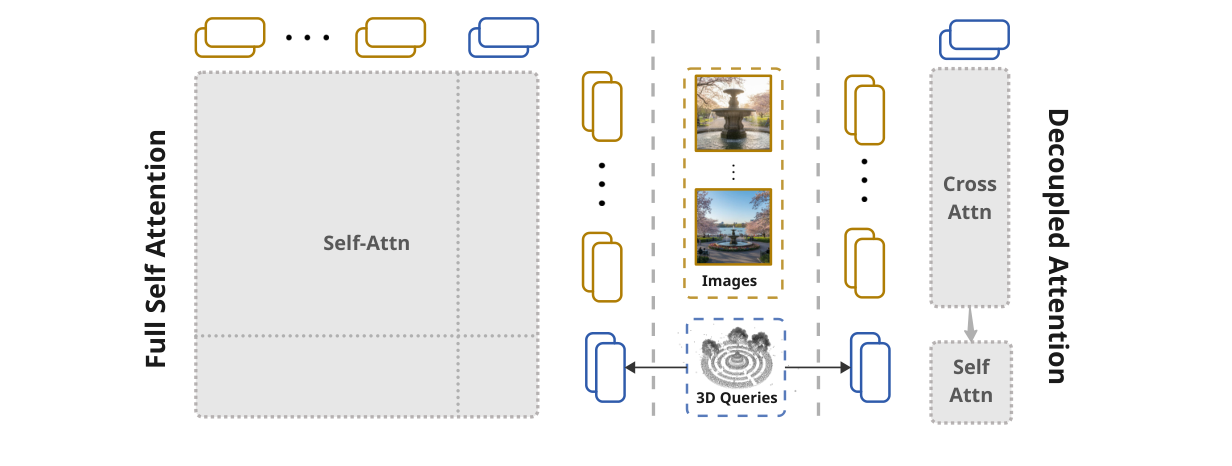
查询是场景表示,而不是像素索引。 默认使用 $Q=4096$ 个可学习查询。初始化时一半从预测点图采样,先贴近已观测表面;另一半作为空间锚点在归一化场景范围内初始化。两类查询之后都可以由网络移动,并不被约束在表面上。查询 Transformer 共 12 层,每层先让查询对图像 token 做交叉注意力,再在查询之间做自注意力。若把所有图像 token 与查询拼在一起做全自注意力,代价随二者总长度平方增长;解耦设计把主要项变为 $O(QNT+Q^2)$($N$ 为视图数,$T$ 为每幅图像 token 数),更适合多视图输入。图 3 展示了两种注意力结构的区别。
每个查询生成一个局部高斯簇。 查询输出一个位置修正量和局部高斯属性,再生成 $K=64$ 个高斯;默认总数为 $QK=262{,}144$。高斯中心由查询位置、查询修正量和局部偏移共同决定,另外预测颜色、尺度、旋转与不透明度。高斯通过可微 splatting 渲染成 RGB 和深度图,因此训练不需要真值三维点云或真值高斯。
训练监督视图是输入视图的超集:例如输入 3 帧时,论文会监督这些输入帧以及额外的 held-out 视图。这样,若某处只在目标视角可见,渲染空洞也会产生损失,促使查询把高斯放到输入图像未直接覆盖的区域。损失包括 RGB 重建(第一阶段含 L1 与 LPIPS,高分辨率微调阶段省去 LPIPS)、渲染深度的尺度不变损失,以及几何主干的相机损失。
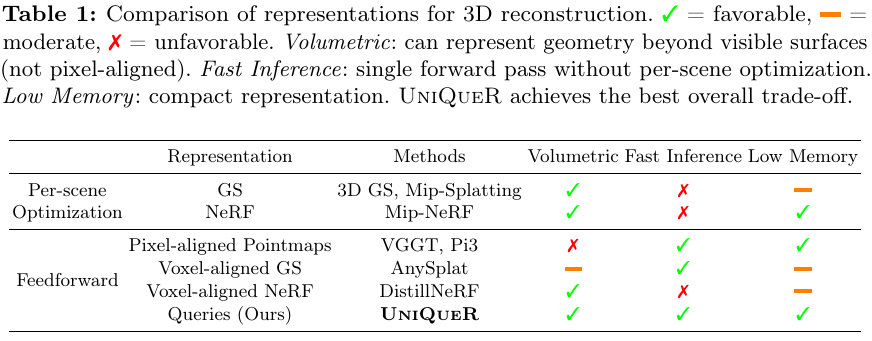
论文的表 1 是表示方式的定性归类:它把逐场景优化、像素/体素对齐前馈模型和查询表示按体积表达能力、单次推理与内存做比较。这里的勾选是作者的概念性总结,不是统一协议下的量化基准。
数据集
训练数据来自 DL3DV-10K、ScanNet++、BlendedMVS 和 Co3D。新视角合成在 Mip-NeRF 360、VR-NeRF 和 RealEstate10K 的 150 个测试场景子集上评估;相机姿态在 RealEstate10K 与 Co3Dv2 上评估。稀疏视图实验将输入与测试视图严格分开,并对每个场景的 5 组视图采样取平均,以缓和视角挑选带来的方差。几何精度用渲染深度相对真值深度的 Abs Rel 衡量。
算力
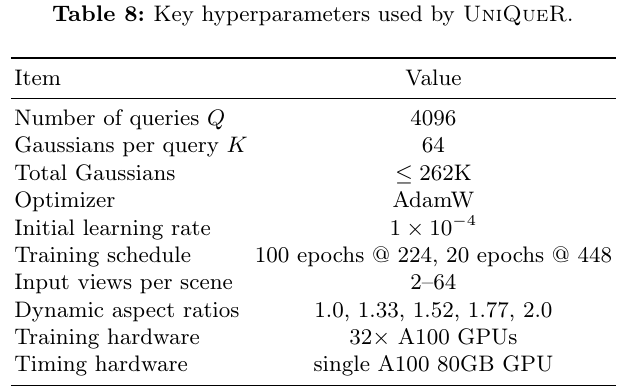
模型以 AdamW 训练:224 分辨率训练 100 个 epoch,再在 448 分辨率微调 20 个 epoch,训练使用 32 张 A100 GPU。网络总参数约 1.393B,其中约 502.31M 可训练,约 890.99M 的预训练几何主干保持冻结。论文未明确给出完整训练耗时和训练 batch size。表中推理时间则是在单张 A100 80GB、batch size 1 上测得。
附录列出的默认配置包括每场景 2–64 个输入视图、4096 个查询、每查询 64 个高斯,以及训练时使用的动态宽高比。表 8 汇总了这些设置。
实验结果
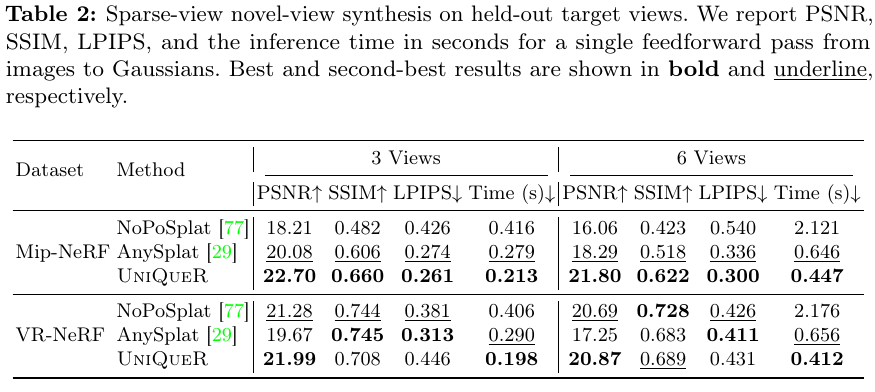
稀疏视图新视角合成。 在 Mip-NeRF 360 上,UniQueR 的 3-view 结果为 22.70 / 0.660 / 0.261(PSNR / SSIM / LPIPS),6-view 为 21.80 / 0.622 / 0.300,三项都超过表中 NoPoSplat 与 AnySplat。VR-NeRF 上则不能说全面领先:UniQueR 的 PSNR 最高(3-view 21.99,6-view 20.87),但 3-view 的 SSIM 与 LPIPS、以及 6-view 的 SSIM 与 LPIPS 均逊于至少一个对比方法。对应完整结果和单次前馈耗时见表 2。
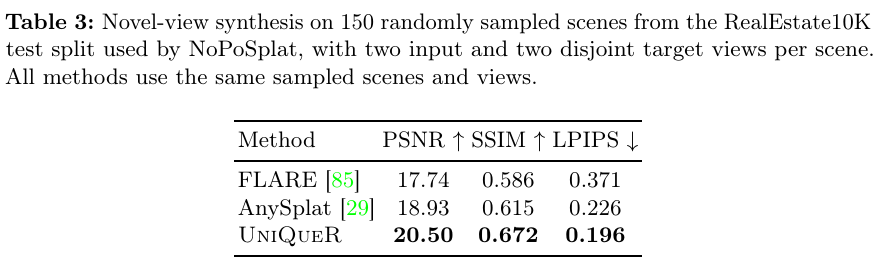
在两张输入图像的 RealEstate10K 子集上,UniQueR 达到 20.50 PSNR、0.672 SSIM 和 0.196 LPIPS,优于同表中的 FLARE 与 AnySplat。表 3 的场景数量为 150,输入与目标视图互不重叠。
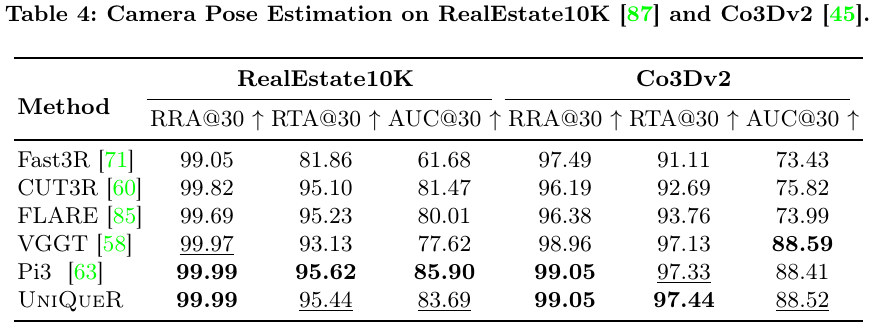
姿态、稠密视图与效率。 相机估计整体接近 Pi3:在 RealEstate10K 的 RRA@30 / RTA@30 / AUC@30 为 99.99 / 95.44 / 83.69,在 Co3Dv2 为 99.05 / 97.44 / 88.52;不同指标上与 Pi3 各有高低,不能概括成全面超过。
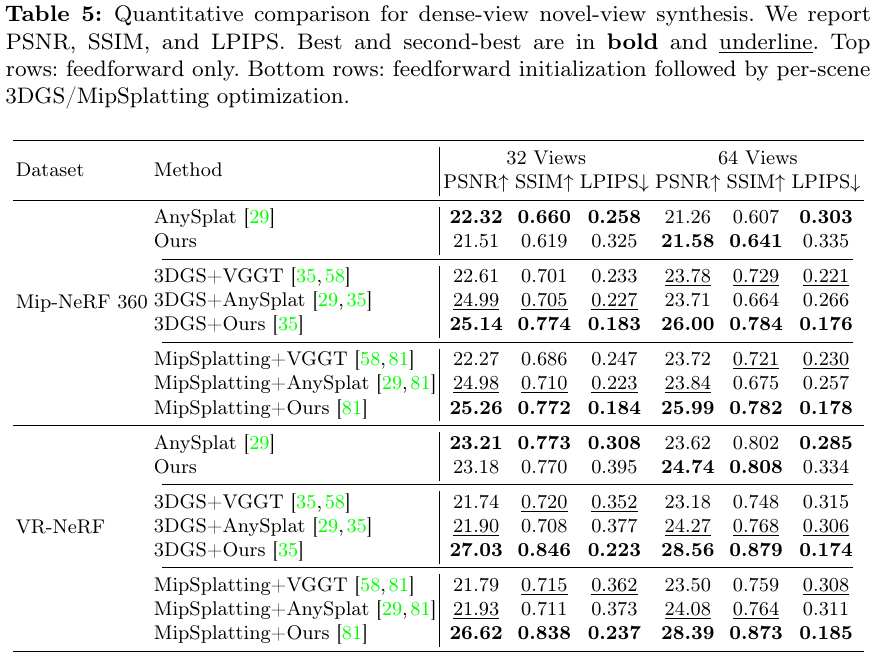
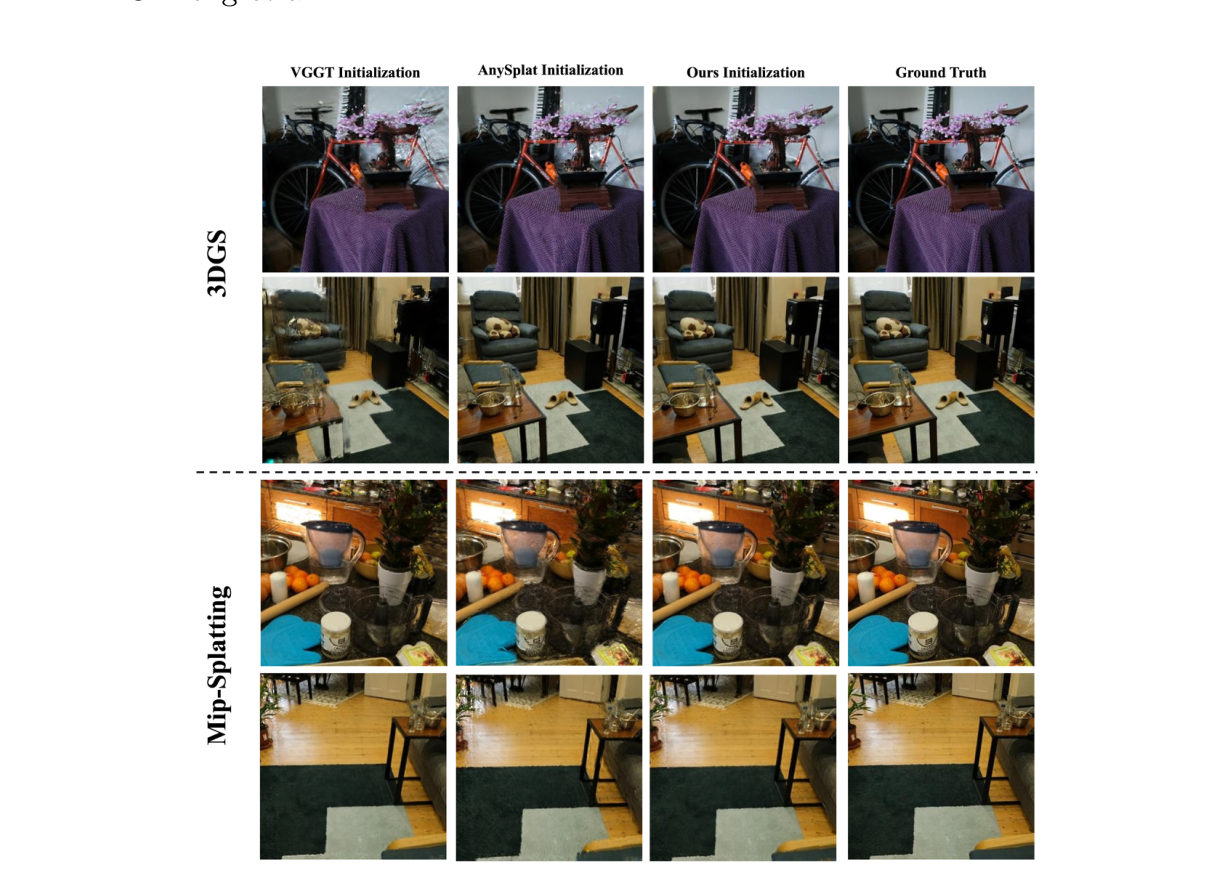
稠密视图实验同样呈现指标取舍。UniQueR 的前馈结果在部分 64-view PSNR/SSIM 上有竞争力,但不是所有数据集或 LPIPS 指标都占优;更明显的收益出现在把预测结果作为逐场景优化初始化时,表 5 中 3DGS / Mip-Splatting + UniQueR 在多数组合上取得更高的重建质量。
在 32 输入视图、448×448 设置下,表 6 报告 UniQueR 最多 262K 个高斯、11.19 GB 显存、1.97 秒推理和 0.038 深度 Abs Rel;AnySplat 对应为 3.85M、18.42 GB、4.63 秒和 0.062。也就是说,基元数约少 14.7 倍、显存低约 39%、推理快约 2.35 倍,同时渲染深度误差更低。
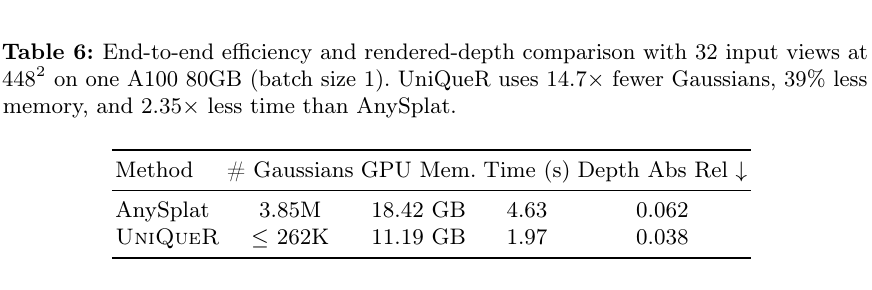
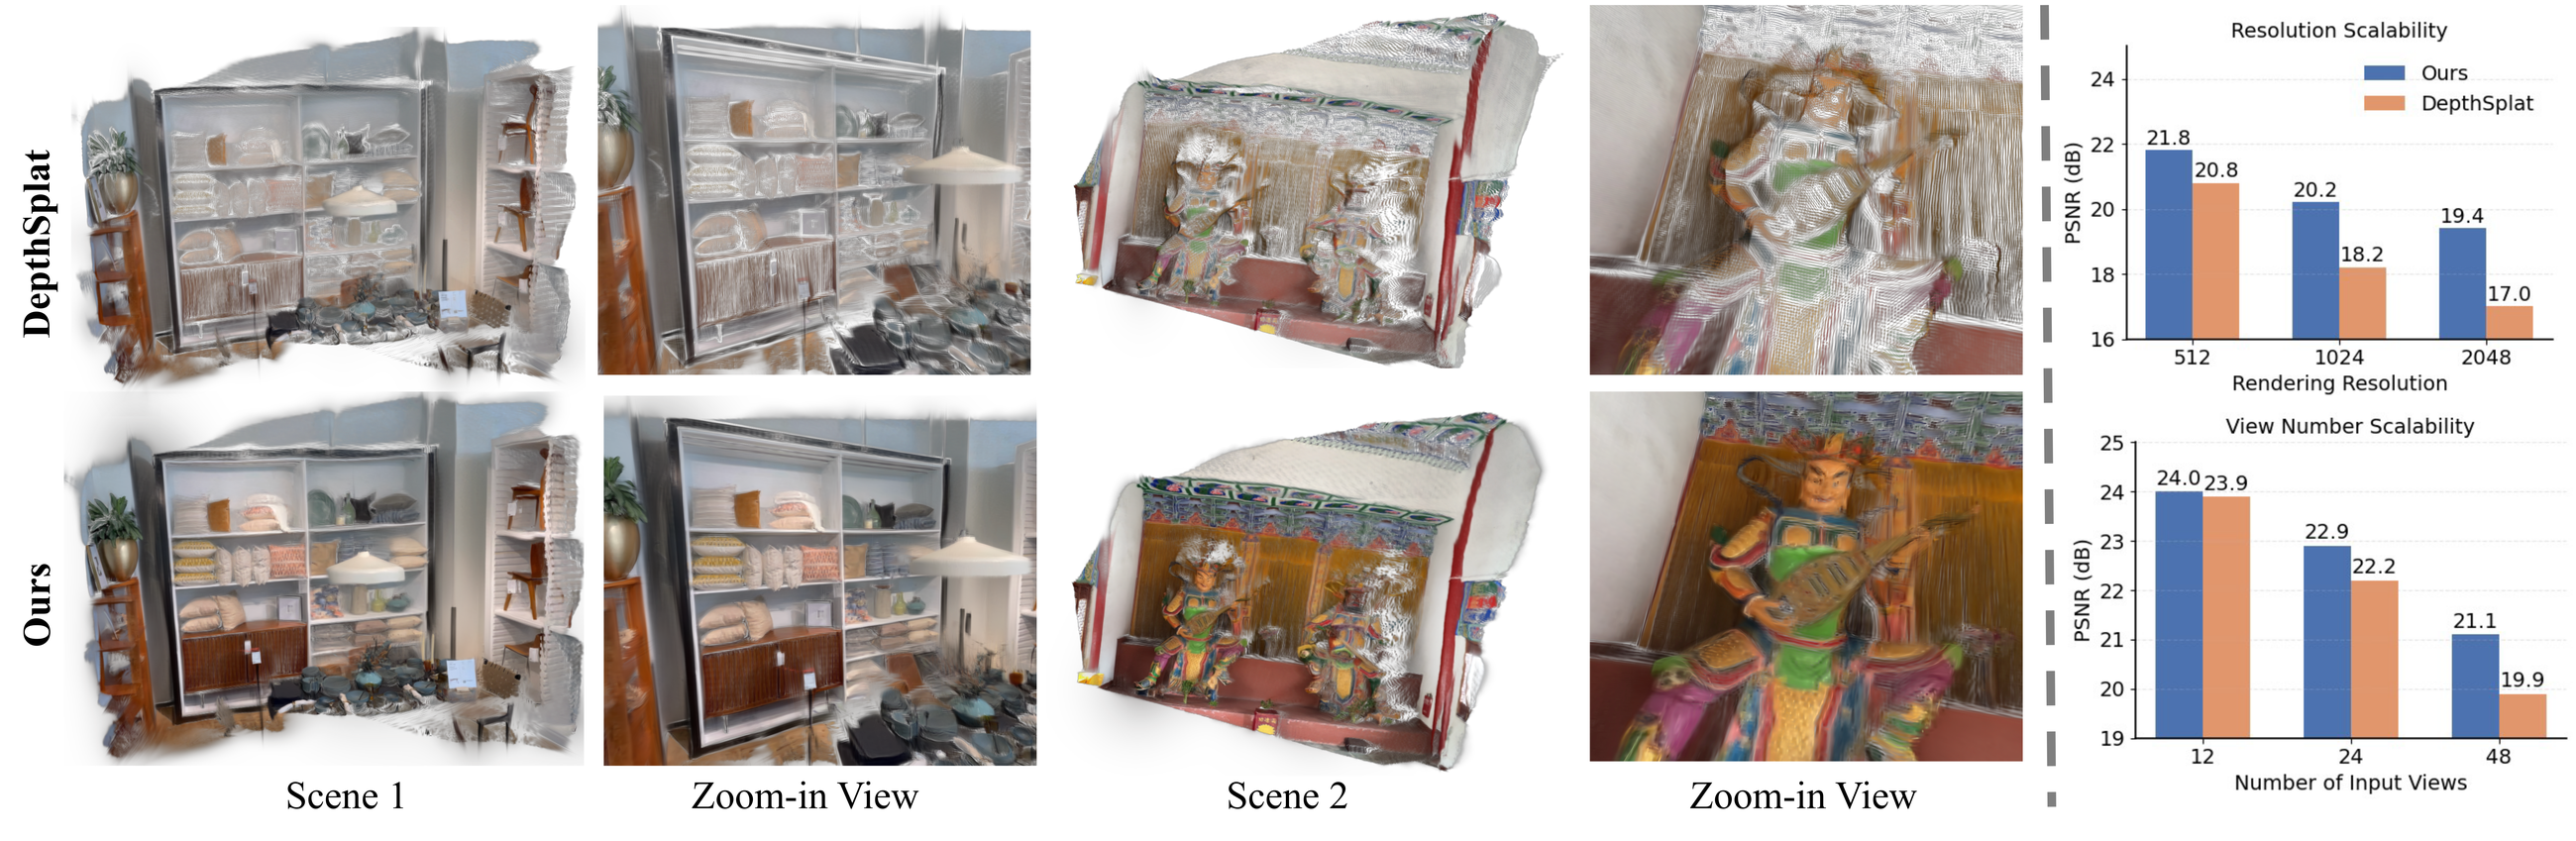
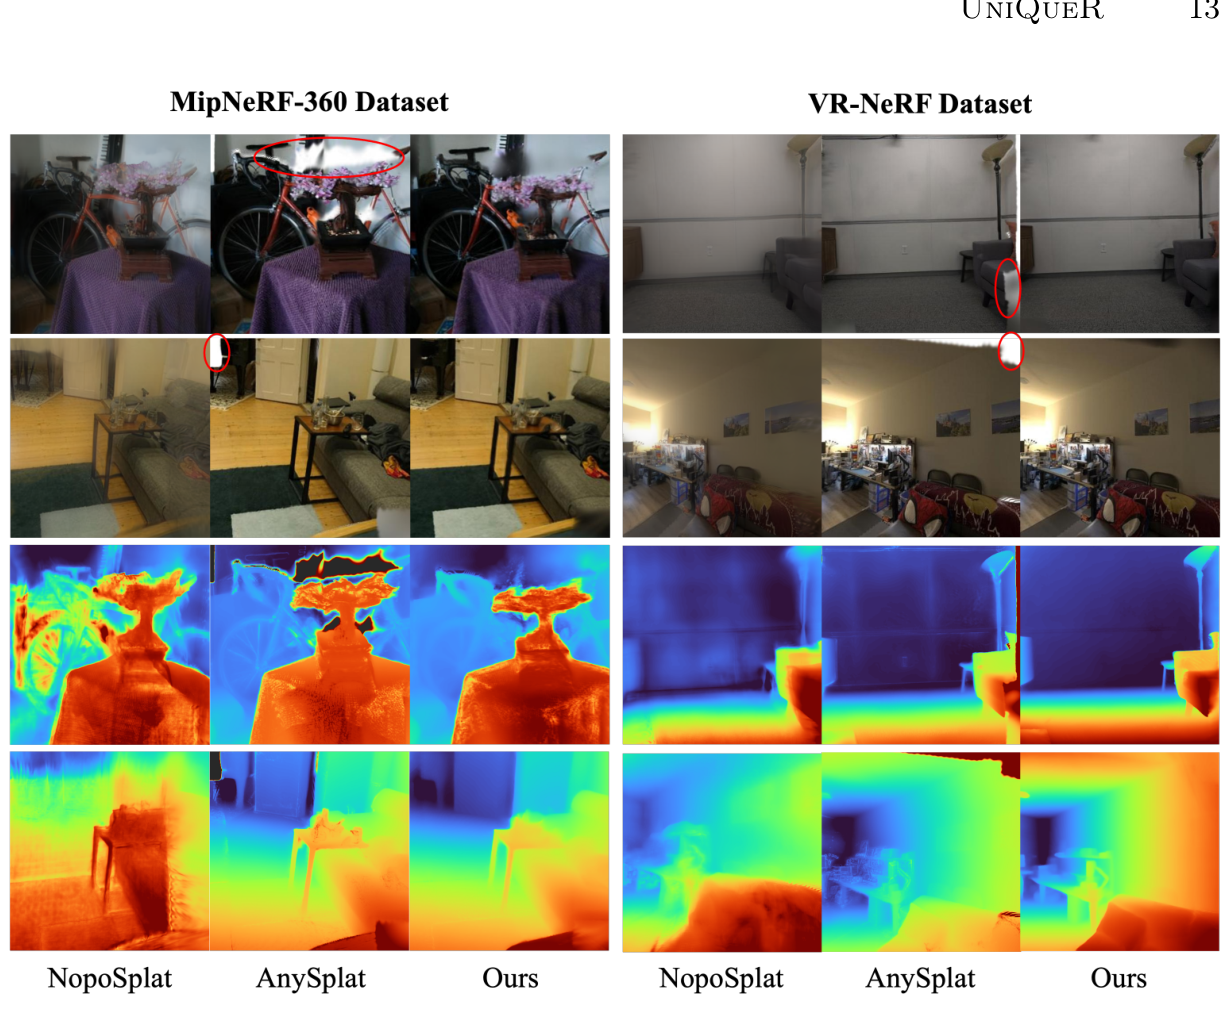
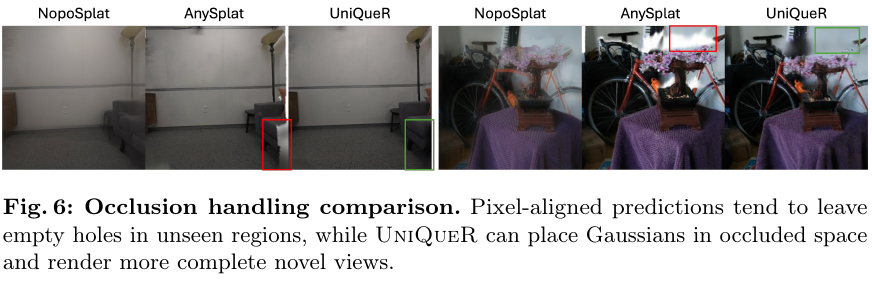
图 4 给出 Mip-NeRF 360 与 VR-NeRF 的 held-out 渲染和深度对比:像素对齐预测在输入覆盖有限处更容易出现空白或深度孔洞,UniQueR 的查询可以把基元放进遮挡区域。不过图像质量仍需结合前述 PSNR、SSIM、LPIPS 的数据集差异一起看。
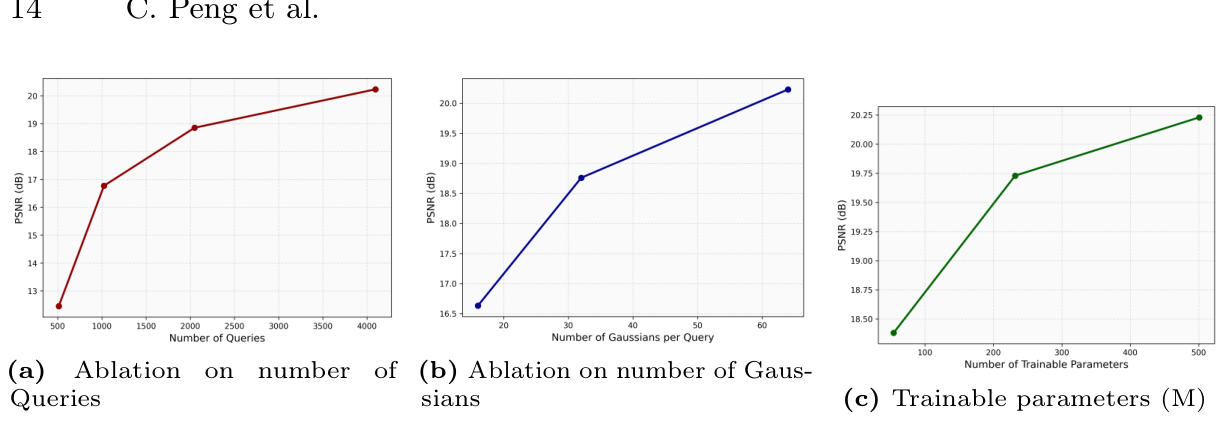
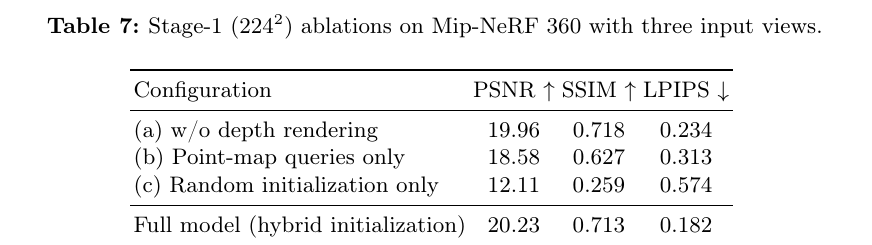
消融与附录结果。 图 5 显示,增加查询数、每查询高斯数或可训练参数规模时,PSNR 总体上升。表 7 进一步说明深度渲染监督和混合查询初始化的重要性:完整模型为 20.23 / 0.713 / 0.182;只用点图查询降至 18.58 / 0.627 / 0.313,纯随机初始化则明显退化到 12.11 / 0.259 / 0.574。去掉深度渲染时 PSNR 与 LPIPS 变差,但 SSIM 略有上升(0.718 对 0.713),因此深度项并非让每个指标都同时改善。
附录图 6 专门展示遮挡处理:像素对齐方法容易在未观察区域留下空洞,3D queries 可利用 held-out 视图监督把高斯放入这些区域。附录图 7 比较了不同初始化经过 3DGS 与 Mip-Splatting 后优化的结果;UniQueR 初始化整体呈现更清楚、结构更稳定的几何。
优势与不足
优势
- 把高斯生成从逐像素/相机射线坐标中解耦,给遮挡与未观测区域留下显式的几何分配自由度。
- 不依赖真值三维点监督;用 RGB、渲染深度、相机损失和 held-out 视图监督训练。
- 固定查询预算把高斯数量与输入分辨率、视图数分开,配合解耦注意力降低稠密多视图表示的显存和延迟。
- 论文同时评估渲染、相机姿态与深度几何,并公开展示前馈初始化对后续逐场景优化的作用。
不足
- 共享场景坐标是非度量规约,不能直接当成具有真实尺度的机器人地图;输入姿态和局部点图也依赖大型预训练几何主干。
- 固定的查询数和每查询高斯数形成容量上限,复杂场景的高频细节与非常规遮挡仍可能不足;作者也指出当前版本针对静态场景。
- 训练使用 32 张 A100,且冻结主干仍很大,训练与部署成本不低。稠密视图下前馈质量也并非所有数据集、感知指标都优于基线。
记忆点
- 像素是证据,查询才是表示: 2D 图像 token 提供观测,场景几何由可移动的 3D 查询承载。
- 用目标视角监督补盲区: 不必直接标注“这里有被遮挡的三维表面”,让高斯从未见目标视角的渲染误差中学会补全。
- 稀疏表示也能服务优化: 前馈高斯不一定单独取代逐场景优化;它也可以先给出更好的几何和相机初始化。
 微信
 支付宝